책 집필 자료는 얼마나, 어떻게 모아야 할까요
2026-10-29
저자 자료 60 · 외부 근거 30 · 방향 자료 10의 비율과, 3R로 필요한 자료만 고르는 방법
책 집필 자료를 모으기 시작하면 대부분 인터넷 기사와 기관 보고서, 다른 사람의 책부터 찾게 됩니다. 찾기 쉽고, 많이 모일수록 든든해 보이기 때문입니다. 그런데 누구나 찾을 수 있는 자료만 AI에게 제공하면, AI도 누구나 쓸 수 있는 원고만을 생성하게 됩니다. 자료를 모으기 전에 무엇을 어떤 비율로 모을지, 모은 자료 가운데 무엇을 AI에게 줄지 정리해 보겠습니다.
책 집필 자료는 60:30:10의 비율로 모읍니다
자료의 구성 비율은 60:30:10을 기준으로 삼습니다.
- 60: 저자 자신의 자료 — 저자가 쓴 글, 강연·상담·업무 기록, 현장 메모, 실패 회고. 다른 책과 구별되는 내용을 만듭니다
- 30: 외부 근거 — 학술 논문, 공식 통계, 기관 보고서, 법령. 저자의 주장을 믿을 수 있게 받쳐 줍니다
- 10: 방향을 잡는 자료 — 집필 의도를 적은 노트와, 저자의 주장에 반대하는 자료(실패 사례 포함). 원고가 한쪽으로 치우치지 않게 합니다
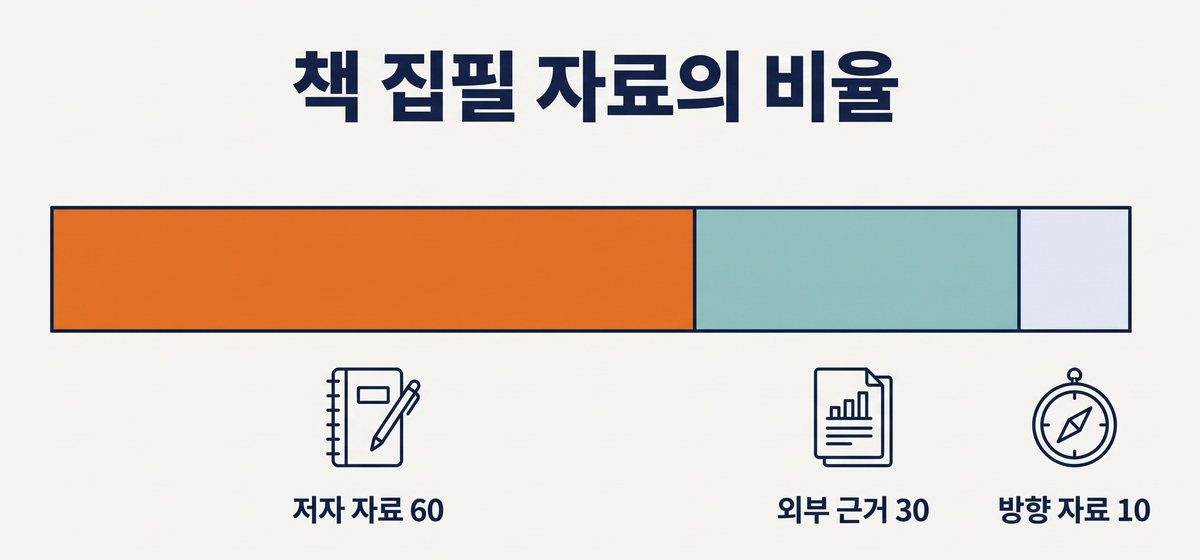
60:30:10은 실험에서 얻은 비율이 아니라, 자료의 비중을 어디에 두어야 하는지에 대한 개념적 기준입니다. 파일 개수를 정확히 맞추라는 것이 아니라, 자료 보관 폴더를 열었을 때 저자 자신의 자료가 가장 많이 보여야 한다는 것입니다.
수집한 자료에는 A·B·C 등급을 매깁니다. A는 학술 논문, 공식 통계, 법령, 저자 본인의 기록처럼 원문 전체를 확보한 1차 자료입니다. B는 언론 보도, 단행본, 협회 보고서이고, 논문이라도 초록만 가지고 있다면 B입니다. C는 커뮤니티 글, 출처를 알 수 없는 글, AI가 생성한 요약입니다. C는 단독 근거로 쓰지 않고, 더 믿을 만한 자료를 찾는 단서로 씁니다.
자료를 많이 넣을수록 AI의 판단은 흐려질 수 있습니다
수집한 자료를 모두 AI에게 넣어 주면 더 좋은 원고가 나올까요? 실제로는 반대인 경우가 많습니다. 자료를 쌓아 두기만 해서 오히려 AI의 판단이 흐려지는 상태를 데이터 비만(Data Obesity)이라고 부릅니다. 벡터 데이터베이스 회사 Chroma가 2025년에 낸 「맥락 부패(Context Rot)」 보고서에 따르면, AI에게 정답이 담긴 문장을 주고 그 곁에 겉보기에는 비슷하지만 정답은 아닌 문장을 하나만 섞어도 답을 맞히는 성능이 떨어졌습니다. 그런 문장이 4개이면 성능이 더 낮아졌습니다. 같은 주제를 조금씩 다르게 말하는 자료 10편은 AI에게 도움이 되기보다 혼란을 줄 수 있습니다. AI에게 자료를 줄 때 중요한 것은 양이 아니라 밀도입니다.
3R 세 질문으로 절마다 필요한 자료만 고릅니다
선별의 기준은 최신성(Recency), 신뢰성(Reliability), 관련성(Relevance) 3가지입니다. 영어 머리글자를 따서 3R이라고 부릅니다.
- 최신성: 지금도 유효한 자료인가? 개정 전의 법령, 새 조사가 나온 뒤의 옛 통계는 뺍니다
- 신뢰성: 누가 썼는지, 원래 출처가 어디인지 밝힐 수 있는가? 작성자가 불분명한 블로그, 출처 없이 옮겨 적은 글은 뺍니다
- 관련성: 목차의 어느 절에 쓸 자료인가? 「언젠가 쓰일지 몰라서」 넣어 둔 자료는 뺍니다
관련성은 가장 판단하기 어렵습니다. 좋은 논문이라도 지금 집필하는 절과 관계가 없으면 AI에게는 잡음이 됩니다. 자료마다 「이 자료가 사라지면 나의 결론이 근본적으로 바뀌는가」를 물어서, 이 질문을 통과한 자료만 남깁니다. 같은 주장을 하는 자료가 여럿이면 등급이 가장 높은 자료 하나만 남기고, 저자의 주장에 동의하는 자료만 남았다면 반대 자료나 실패 사례를 한 건 이상 더합니다. 마지막으로 AI에게 「이 자료만으로 이 절의 핵심 질문에 답할 수 있는가? 부족하면 어떤 자료가 더 필요한지 말해 달라」고 묻습니다.
책의 품질 차이는 저자 자신만이 가진 자료에서 나옵니다
60을 차지하는 저자 자신의 자료를 전유 데이터(proprietary data)라고 부릅니다. 저자 자신만이 가지고 있어서 다른 사람이 인터넷에서 내려받을 수 없는 자료라는 뜻입니다. 60을 전유 데이터에 둔 이유는, AI가 주도권을 가지면 글이 서로 닮아 간다는 연구가 쌓이고 있기 때문입니다. Doshi와 Hauser가 2024년 『Science Advances』에 발표한 실험에서 AI의 아이디어를 받아 쓴 짧은 이야기는 더 창의적이라는 평가를 받았습니다. 그러나 그 이야기들을 서로 비교하면, AI 없이 쓴 이야기들보다 내용이 더 비슷했습니다. 같은 분야의 다른 저자도 같은 AI를 쓰고 있다면, AI가 주는 아이디어는 그 저자에게도 갑니다. AI가 줄 수 없는 것은 저자가 겪은 일과 저자가 남긴 기록뿐입니다.
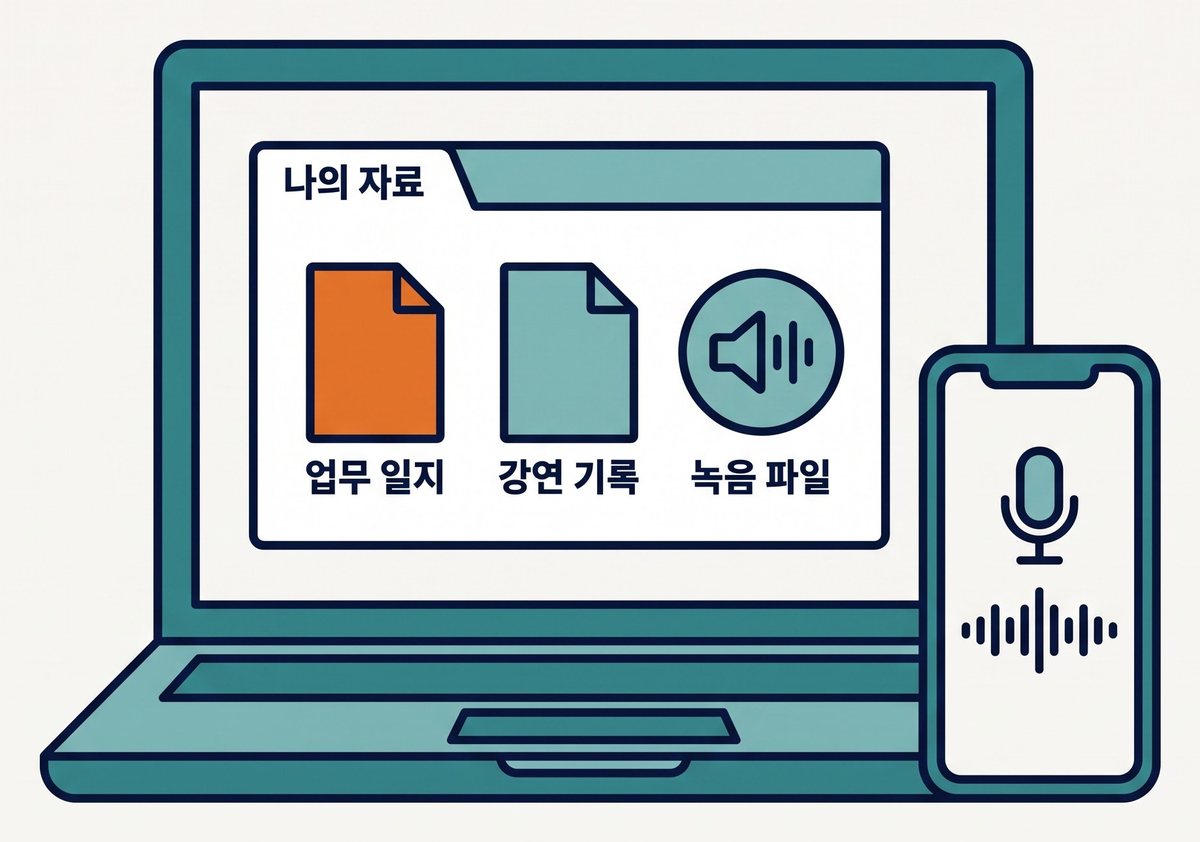
실용서를 집필하는 저자의 전유 데이터는 생각보다 많이 있습니다. 업무 일지, 보고서, 회의록 같은 업무 기록, 강연·상담·교육 기록 같은 현장 기록, 직접 한 설문과 독자에게 받은 질문이 모두 전유 데이터입니다. 이 가운데 가장 놓치기 쉬운 것은 실패 기록입니다. 성공한 이야기는 다른 책에도 많지만, 저자가 실패에서 무엇을 배웠는지는 저자만 말할 수 있습니다.
전유 데이터를 모을 때는 목차의 장마다 「이 장의 핵심 질문과 관련해 내가 직접 겪은 일」을 3가지씩 적고, 그 기록이 이메일, 업무 일지, 사진, 옛 파일 가운데 어디에 남아 있는지 찾습니다. 기록이 남아 있지 않은 경험은 말로 풀어 녹음하고, 녹취록으로 옮깁니다. AI에게 「이 절의 핵심 질문에 대해 저자의 경험을 끌어낼 질문을 10개 해 달라」고 요청해 기억을 되살릴 수도 있습니다. 이때 원자료는 저자가 직접 말하거나 적은 답이고, AI가 정리한 요약은 C 등급의 참고 자료로만 둡니다.
AI는 자료를 정리하고 문장을 생성하는 일을 빠르게 해 줍니다. 그렇지만 어떤 경험을 책의 중심에 둘지는 AI가 대신 정할 수 없습니다. 자료를 모으는 일은 결국 저자 자신만이 보유한 것을 찾아내어, AI가 그것을 읽을 수 있는 자리에 놓아 두는 일입니다. 이 글이 책 집필 자료를 준비하시는 분께 도움이 되기를 바랍니다.
참고한 자료
- Hong, K., Troynikov, A., Huber, J. (2025). Context Rot: How Increasing Input Tokens Impacts LLM Performance. Chroma
- Doshi, A. R., Hauser, O. P. (2024). Generative AI enhances individual creativity but reduces the collective diversity of novel content. Science Advances, 10(28)
이 글은 『AI 도서집필 표준 매뉴얼』 1권(웹편) 3장의 내용을 정리한 것입니다.
자료와 집필 지침을 한곳에 갖추어 두고 집필하는 AI 도서집필 공간, PG 북스튜디오를 소개합니다.
https://peoplegrowth.co.kr/book-studio.html
← 이전 글: 책 한 권 집필 기간은 얼마나 잡아야 할까요 · 글 목록 · 다음 글: 내가 가진 자료를 AI에게 올려도 괜찮을까요 →
AI 보조 저작물 · 이 글의 본문과 그림에는 AI가 생성한 내용을 반영했으며, 인간의 충분한 통제와 검증을 거쳤습니다. (출판계 AI 사용 원칙)