일을 나누어 위임하면 정말 나아질까
2026-09-28
1개의 창에서 여러 개의 창으로
생성형 AI를 쓰는 방식은 오랫동안 1개의 창에서 질문 하나를 던지고 답 하나를 받는 것이었습니다. 그런데 요즘 AI 도구들은 일을 받아 여러 AI에게 나누어 위임하고 결과를 모아 확인하는 쪽으로 바뀌고 있습니다. 구글도 2026년 5월 개발 도구 안티그래비티(Antigravity) 2.0을 발표하면서, 에이전트를 지휘하는 데 초점을 둔 별도의 앱과 주 에이전트가 하위 에이전트를 스스로 띄우는 기능을 내놓았습니다. 비서 한 명에서 하나의 팀으로 옮겨 가는 셈입니다. 그렇다면 일을 나누어 위임하면 결과도 정말 나아질까요?
버튼을 열두 번 누르던 일
저는 12시간 분량의 강의를 준비하면서 회차마다 슬라이드를 한 세트씩, 모두 열두 세트를 만들어야 했습니다. 자료를 바탕으로 슬라이드를 만들어 주는 도구는 훌륭했지만 한 번에 한 가지 작업만 할 수 있었습니다. 프롬프트를 열두 번 쓰고, 생성 버튼을 열두 번 누르고, 끝날 때까지 지켜보아야 했습니다. 도구가 똑똑해도 일을 나누고 이어 붙이는 것은 여전히 사람의 몫이었습니다.
목표 하나를 주었더니 생긴 일
그래서 AI 에이전트와 그 도구를 연결하고, "12강짜리 슬라이드 전체 구조를 연계성 있게 기획해서 다 만들어 달라"는 목표 하나만 주어 보았습니다. 에이전트는 먼저 열두 회차의 흐름을 설계했습니다. 이어서 회차별 세부 지시문 열두 개를 스스로 쓰고 슬라이드 생성을 차례로 요청했습니다. 결과를 지켜보다가 오타나 규격 누락이 보이면 지시문을 고쳐 다시 만들게 했습니다. 에이전트가 쓴 지시문은 대략 이런 구조였습니다.
총 12시간 분량 강의 중 제N회차에 해당하는 자료입니다. 이전 회차와 다음 회차의 연결성을 유지하십시오. 분량은 15장, 도입-전개-결론
엄밀히 말하면 여러 AI가 동시에 일한 것은 아닙니다. 전체를 설계하는 쪽과 한 회차씩 만드는 쪽이 나뉘었고, 그 사이를 "이전 회차와 다음 회차의 연결성"이라는 하나의 맥락이 이었습니다. 제가 한 일은 버튼을 누르는 것이 아니라 목표를 정하고 결과를 확인하는 것으로 바뀌었습니다.
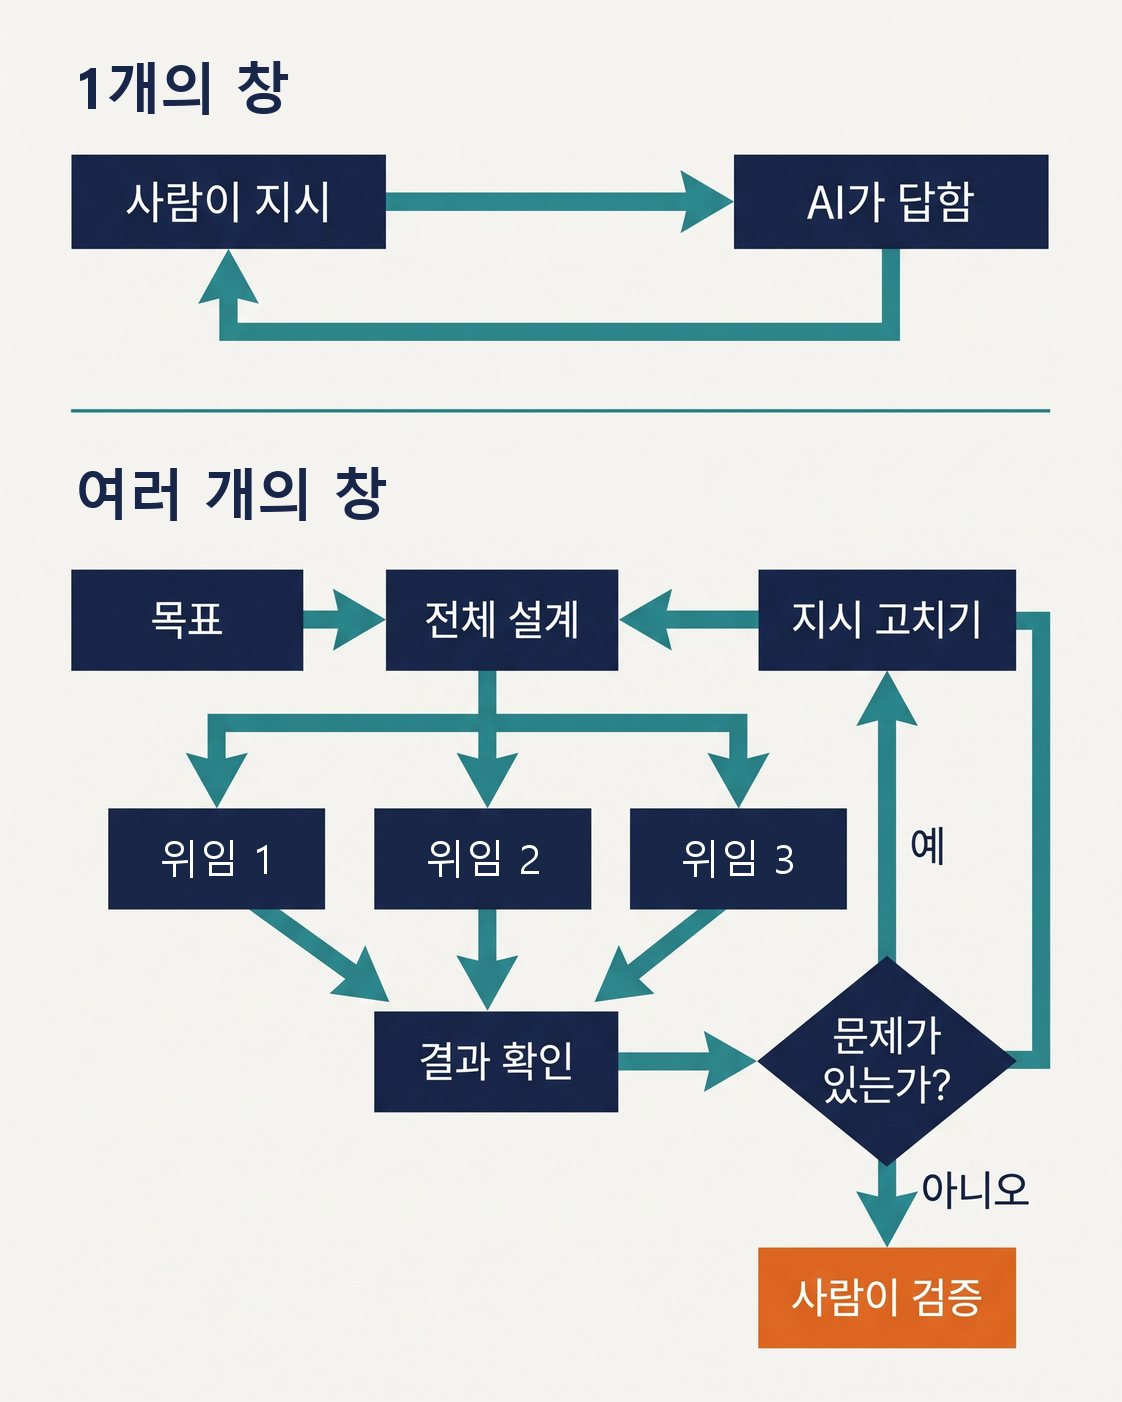
나누면 나아지는 일, 나누면 어긋나는 일
나누면 언제나 나아질까요? 연구 결과는 일의 성질에 따라 다르다고 말합니다. 앤트로픽(Anthropic)은 2025년 자사의 조사 기능을 설명하면서, 주 에이전트 하나가 하위 에이전트 여럿에게 조사를 나누어 위임한 방식이 단일 에이전트보다 내부 평가에서 90.2% 더 좋은 성과를 냈다고 밝혔습니다. 예를 들어 여러 기업의 이사진을 모두 찾는 일은 나누어 위임한 쪽이 답을 찾았고, 혼자 차례로 검색한 쪽은 찾지 못했습니다. 동시에 여러 방향을 살펴야 하는 일이었기 때문입니다.
반대의 결과도 있습니다. 구글 연구진 등이 참여한 Kim et al.(2025)은 여섯 가지 과제에서 에이전트 구성을 바꾸어 가며 비교했습니다. 나누기 좋은 재무 분석 과제에서는 단일 에이전트보다 성과가 80.8% 올랐지만, 순서대로 이어서 계획해야 하는 과제에서는 70.0%까지 떨어졌습니다. 나란히 해도 되는 일은 나누면 나아지지만, 앞의 결과를 이어받아야 하는 일은 나누면 이음매에서 어긋나기 쉽다는 뜻입니다.
쪼개는 일과 확인하는 일은 사람에게 남습니다
그래서 일을 위임하는 단위가 커질수록 사람에게 필요한 능력도 달라집니다. 프롬프트를 잘 쓰는 기술보다 일을 잘 쪼개는 능력과 돌아온 결과를 잘 검증하는 능력이 중요해집니다. 앤트로픽도 지시가 자세하지 않으면 에이전트들이 같은 일을 겹쳐 하거나 빈틈을 남긴다고 적었습니다. 여러 에이전트 시스템의 실패를 분석한 Cemri et al.(2025)은 작업 기록 150건을 분석해 실패 유형 열네 가지를 찾아 세 유형으로 묶고, 이를 1,600건이 넘는 기록에 적용했는데, 그 가운데 하나가 결과를 제대로 확인하지 못해 생기는 실패였습니다. 목표가 모호하면 결과도 모호해지고, 확인하지 않으면 틀린 결과가 그대로 넘어옵니다.
나누어도 넘길 수 없는 것
나누어 위임하는 방식에는 분명한 값이 따릅니다. 앤트로픽은 여러 에이전트 시스템이 일반 대화보다 토큰을 약 15배 더 쓴다고 밝혔고, 여러 에이전트가 같은 맥락을 공유해야 하거나 서로 의존하는 부분이 많은 일에는 아직 맞지 않는다고 했습니다. 회사 내부 자료를 외부 서버로 보낼 수 없는 환경이라면 도입 자체가 어렵고, 도구가 빠르게 바뀌는 만큼 익히는 시간도 비용입니다. 무엇보다 에이전트가 스스로 고쳐 가며 일을 끝냈다고 해서 그 결과가 옳다는 보장은 없습니다. 무엇을 나눌지, 돌아온 결과를 받아들일지는 끝까지 사람이 판단해야 합니다. 도구가 좋아질수록 사람의 판단력이 더 중요해지는 까닭입니다.
참고한 연구
- Anthropic, How we built our multi-agent research system (2025) https://www.anthropic.com/engineering/multi-agent-research-system
- Kim et al., Towards a Science of Scaling Agent Systems (arXiv:2512.08296, 2025) https://arxiv.org/abs/2512.08296
- Cemri et al., Why Do Multi-Agent LLM Systems Fail? (arXiv:2503.13657, 2025) https://arxiv.org/abs/2503.13657
- Google Antigravity, Google Antigravity @ I/O 2026 (2026) https://antigravity.google/blog/google-io-2026