질문을 잘하는 것만으로 충분할까
2026-09-21
질문에서 판단 구조의 설계로
생성형 AI를 자주 사용하시는 분들께 가장 자주 듣는 말이 있습니다.
"AI에게 같은 질문과 요청을 했는데 저분은 왜 저런 답을 받을까요."
대개는 모델을 탓하십니다. 어느 모델이 더 똑똑한지 물으시고, 요금제를 올리면 달라지는지 물으십니다. 그런데 제가 여러 산업과 직군에서 강의를 하며 본 차이는 모델에서 오지 않았습니다.
결과물을 만드는 것은 세 가지입니다
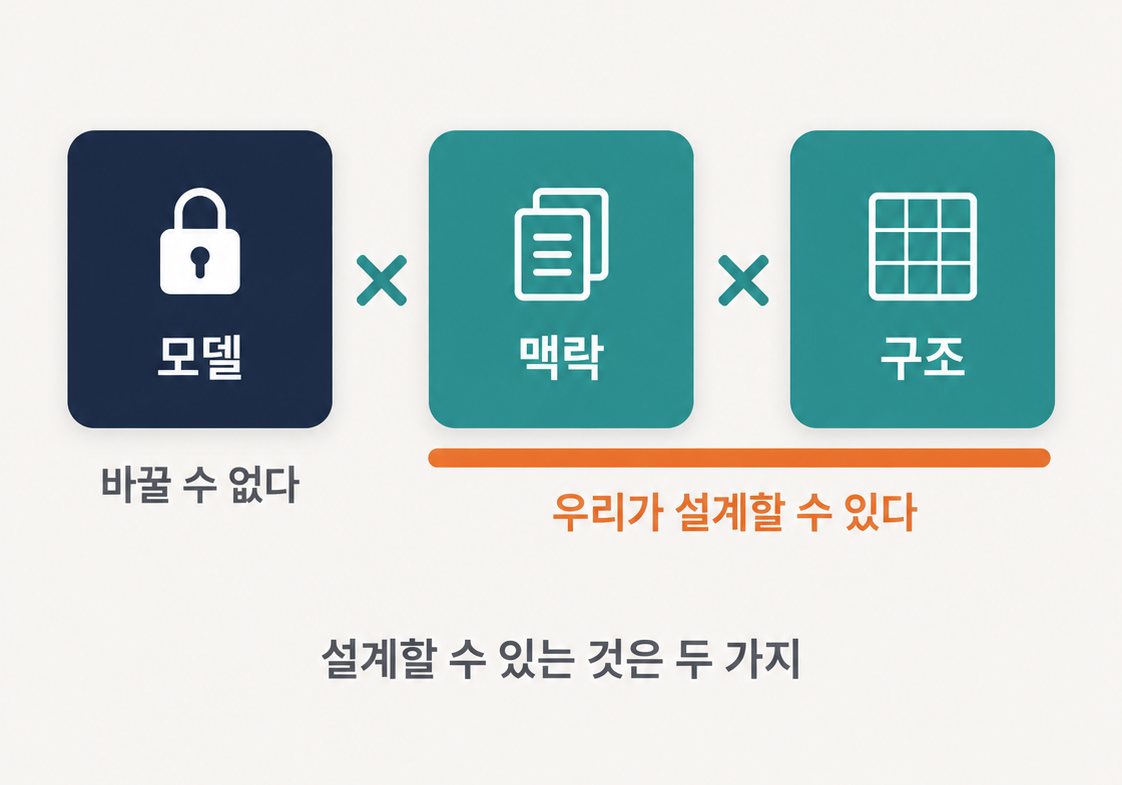
저는 AI의 결과물을 세 가지가 곱해진 것으로 봅니다. 모델과 맥락과 구조입니다.
모델은 연산 능력이어서 고를 수는 있어도 우리가 바꿀 수는 없고, 맥락은 AI가 판단의 근거로 삼는 정보 환경이며, 구조는 AI가 생각하는 순서를 그려 놓은 설계도입니다. 세 가지 가운데 두 가지는 우리가 설계할 수 있는데도, 많은 분이 통제할 수 없는 한 가지(모델)에 관심을 쏟으시고 정작 설계할 수 있는 두 가지(맥락과 구조)는 소홀히 하십니다.
정확히 말하면 모델이 결과의 품질을 결정하지 않는다는 뜻은 아닙니다. 어려운 추론에서는 모델의 차이가 분명히 드러납니다. 다만 일상의 실무에서 결과를 좌우하는 것은 모델이 아니라 나머지 두 가지인 경우가 많습니다.
질문과 작업 설계는 다릅니다
"이 주제를 설명해 주세요"라고 요청하는 것과 "이 주제의 핵심 요약과 판단의 틀, 실행 단계까지 포함한 분석을 작성해 주세요"라고 요청하는 것은 겉보기에 비슷하지만, 앞의 것은 설명을 구한 것이고 뒤의 것은 받을 결과물의 모양을 미리 정해 둔 것입니다.
차이는 작은데 결과는 크게 달라집니다. 뒤의 요청에는 무엇을 만들어야 하는지와 어떤 상태가 되면 끝난 것인지가 함께 들어 있어서, AI가 스스로 판단해 채워야 할 빈자리가 그만큼 줄어들기 때문입니다.
그래서 저는 프롬프트를 질문이라고 부르지 않고 작업 지시서에 가깝다고 말씀드립니다. 사람에게 일을 맡길 때를 떠올려 보시면 분명해집니다. 숙련된 관리자는 "알아서 잘해 주세요"라고 말하지 않고, 무엇을 언제까지 어떤 형태로 받을지를 먼저 정합니다.
일을 시키기 전에 방법을 먼저 설계하게 합니다
한 걸음 더 들어가면, AI에게 바로 일을 시키지 않고 그 일을 잘하기 위한 방법론부터 설계해 달라고 요청하는 길이 있습니다. 저는 이것을 프롬프트를 만드는 프롬프트, 곧 메타 프롬프트(Meta Prompt)라고 부릅니다.
메타 프롬프트 접근 방식의 유용성은 Wang et al.(2023)의 연구 논문에서도 확인됩니다. 이 논문이 제안한 계획 후 실행(Plan-and-Solve) 프롬프팅은 과업을 바로 풀게 하지 않고, 전체를 작은 하위 과업으로 나누는 계획을 먼저 세우게 한 다음 그 계획대로 수행하게 합니다. 연구진이 이 순서를 고안한 까닭은 AI가 중간 단계를 통째로 건너뛰는 오류를 줄이기 위해서였습니다.
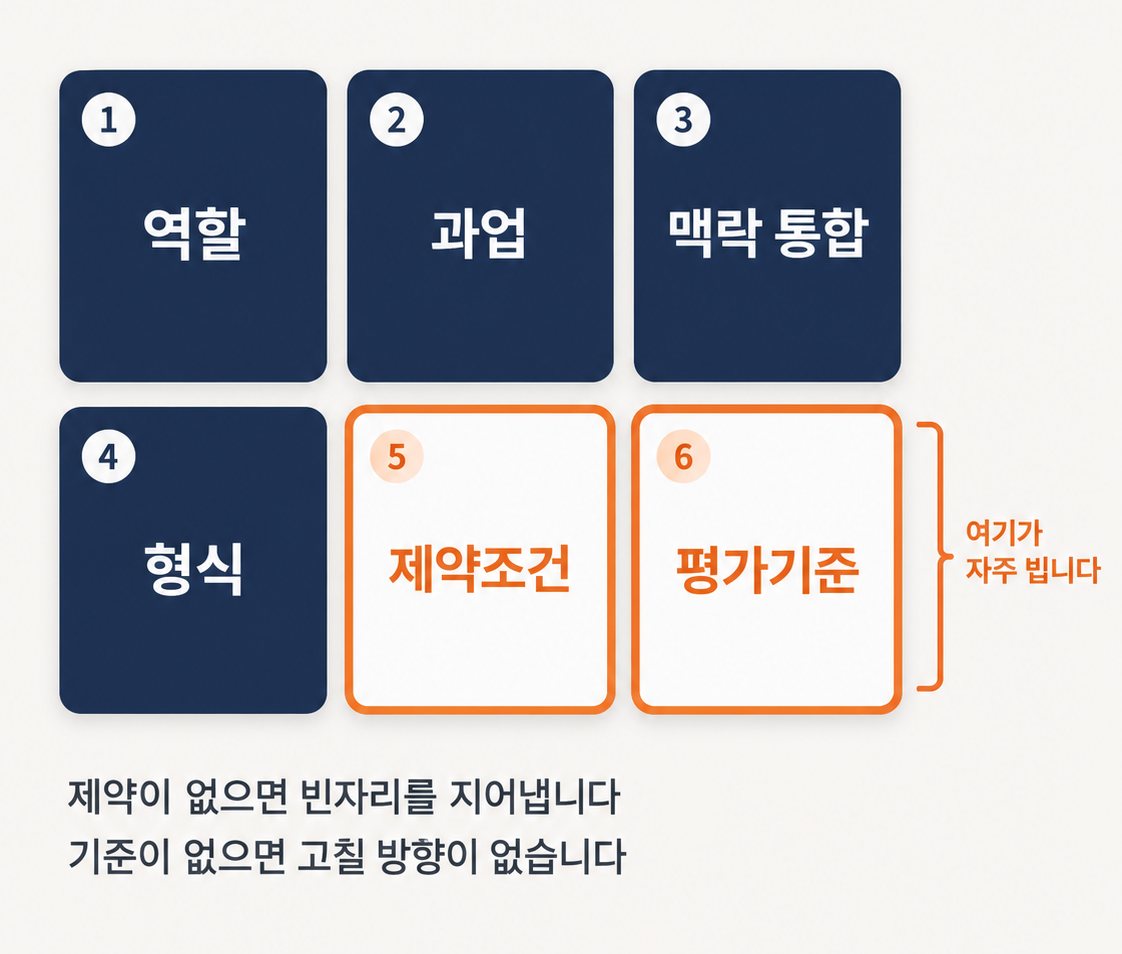
메타 프롬프트에는 여섯 가지가 들어갑니다. 역할은 전문가라는 말로는 부족해서 까다로운 투자 심사역이나 엄격한 동료 심사위원처럼 판단의 태도까지 정해 주어야 하고, 과업은 수행할 목표를 구체적으로 적으며, 맥락 통합은 올린 자료를 어떻게 쓸 것인지 명시합니다. 형식은 표인지 보고서인지 출력 양식을 지정하는 자리이고, 제약조건은 자료에 없는 내용을 추론하지 않는다는 선을 긋는 자리이며, 평가기준은 결과물의 품질을 무엇으로 판단할지 미리 주는 자리입니다.
여섯 가지 요소 가운데 실무에서 가장 자주 놓치는 것이 마지막 두 가지, 제약조건과 평가기준입니다. 제약이 없으면 AI는 빈자리를 그럴듯한 문장으로 메우고, 평가 기준이 없으면 고칠 방향 자체가 생기지 않습니다.
역할에 대해서는 한 가지를 덧붙이겠습니다. Zheng et al.(2023)이 162개 역할과 2,410개 사실 질문으로 네 개 모델군을 검증한 연구에서, "당신은 도움이 되는 조수입니다"처럼 역할 이름표를 붙이는 것만으로는 성능이 올라가지 않았습니다. 저는 이 결과를 역할이 쓸모없다는 뜻이 아니라, 이름표가 아니라 판단의 태도와 기준이 실제로 일한다는 뜻으로 받아들입니다.
강의장에서 자주 보는 장면이 있습니다. 결과물이 마음에 들지 않아 다시 써 달라고 요청하고 또 마음에 들지 않아 다시 요청하는 일이 서너 번 이어지는데, 그때 무엇이 부족하신지 여쭈면 대개 "좀 밋밋해서요"라고 답하십니다. 밋밋하다는 말은 사람에게는 통하지만 AI에게는 통하지 않습니다. 사실과 의견이 섞여 있는지, 주장마다 근거가 붙어 있는지, 독자가 한 번에 이해할 문장인지를 적어 주시면 같은 요청이 다른 요청이 됩니다.
요약하기 전에 비어 있는 것을 먼저 묻습니다
자료를 올리고 바로 요약을 요청하는 것은 아까운 일입니다. 요약은 있는 것만 보여 주고 없는 것은 보여 주지 않기 때문입니다.
이 순서는 컨설팅에서 오래 쓰여 온 방식이기도 합니다. 맥킨지에서 정리되어 바버라 민토의 『피라미드 원칙』으로 알려진 상호 배제와 전체 포괄(MECE)은, 자료를 요약하기 전에 논리의 칸이 다 채워졌는지부터 확인하게 만듭니다.
그래서 저는 요약보다 먼저 이렇게 요청합니다.
당신은 전략 컨설턴트입니다. 올린 자료들을 상호 배제와 전체 포괄(MECE)의 관점에서 분석하십시오. 지금 자료만으로 이 보고서를 쓰기에 부족한 정량적 근거와 논리적 공백이 무엇인지 식별하고, 그것을 메우기 위한 심층 조사 질문을 만들어 주십시오.
이 한 번을 거치면 다음 요청의 수준이 달라집니다. 무엇이 비어 있는지 알고 쓰는 글과 모르고 쓰는 글은 같은 자료에서 나와도 다른 글이 됩니다.
판단 구조로도 되지 않는 것
여기까지 읽으시고 난 뒤, 단지 구조만 잘 설계하면 된다고 해석하지 않기를 바랍니다.
판단 구조는 AI가 답을 만들어 가는 과정을 다듬어 주지만, 그렇게 나온 답이 사실인지까지는 판단해 주지는 못합니다. 평가 기준을 아무리 촘촘히 주어도 AI는 그 기준에 맞추어 스스로를 후하게 평가할 수 있고, 근거로 삼은 자료가 낡았거나 틀렸다면 구조는 그 틀린 것을 더 정연한 모습으로 만들어 낼 뿐입니다.
이것은 우려만은 아닙니다. Huang et al.(2023)의 연구는 외부에서 주는 피드백 없이 AI가 자기 힘만으로 답을 고치게 했을 때 추론 과제에서 제대로 고치지 못했고, 때로는 고친 뒤에 오히려 나빠졌다고 보고했습니다. 이전 글(Self-Refine)에서도 다루었지만, 자기 교정은 같은 AI가 자기 답을 스스로 평가하고 고치는 방식입니다. 평가 기준은 사람이 정해 주어도 그 기준을 채웠는지 판정하는 것은 AI 자신이어서, 중요한 문서라면 원자료와 대조하는 검증이 따로 있어야 합니다.
그래서 저는 구조를 설계한 뒤에 한 가지를 더 둡니다. 결과물에 담긴 사실을 원문에서 다시 평가하는 일이고, 이 일만큼은 사람이 합니다.
AI를 잘 쓴다는 것은 더 빨리 그럴듯한 것을 얻는 일이 아니라, 무엇을 맡기고 무엇을 끝까지 쥐고 있을지를 판단하는 일에 가깝습니다.
참고한 연구
- Wang et al., Plan-and-Solve Prompting (arXiv:2305.04091, 2023) https://arxiv.org/abs/2305.04091
- Zheng et al., When "A Helpful Assistant" Is Not Really Helpful (arXiv:2311.10054, 2023) https://arxiv.org/abs/2311.10054
- Huang et al., Large Language Models Cannot Self-Correct Reasoning Yet (arXiv:2310.01798, 2023) https://arxiv.org/abs/2310.01798
- Barbara Minto, 『The Pyramid Principle』 (1987) https://www.barbaraminto.com/textbook