생성형 AI에게 한국어로 질문을 하면 손해를 볼까
2026-09-22
의미 덩어리와 토큰 사이
생성형 AI를 한국어로 사용하시는 분들께 자주 듣는 말이 있습니다.
"한국어로 명확하게 질문했는데, 답변이 기대한 것과 다릅니다."
그럴 때면 한국어로 질문한 탓인지, 영어로 질문했다면 달랐을지 궁금해지기 마련입니다. 제 답은 반은 그렇고 반은 아니라는 것입니다. 한국어로 질문할 때 불리해지는 자리는 실제로 있지만, 처리 비용과 이해의 깊이와 질문에 빠진 정보는 원인이 서로 다르고, 원인이 다르면 푸는 방법도 달라집니다.
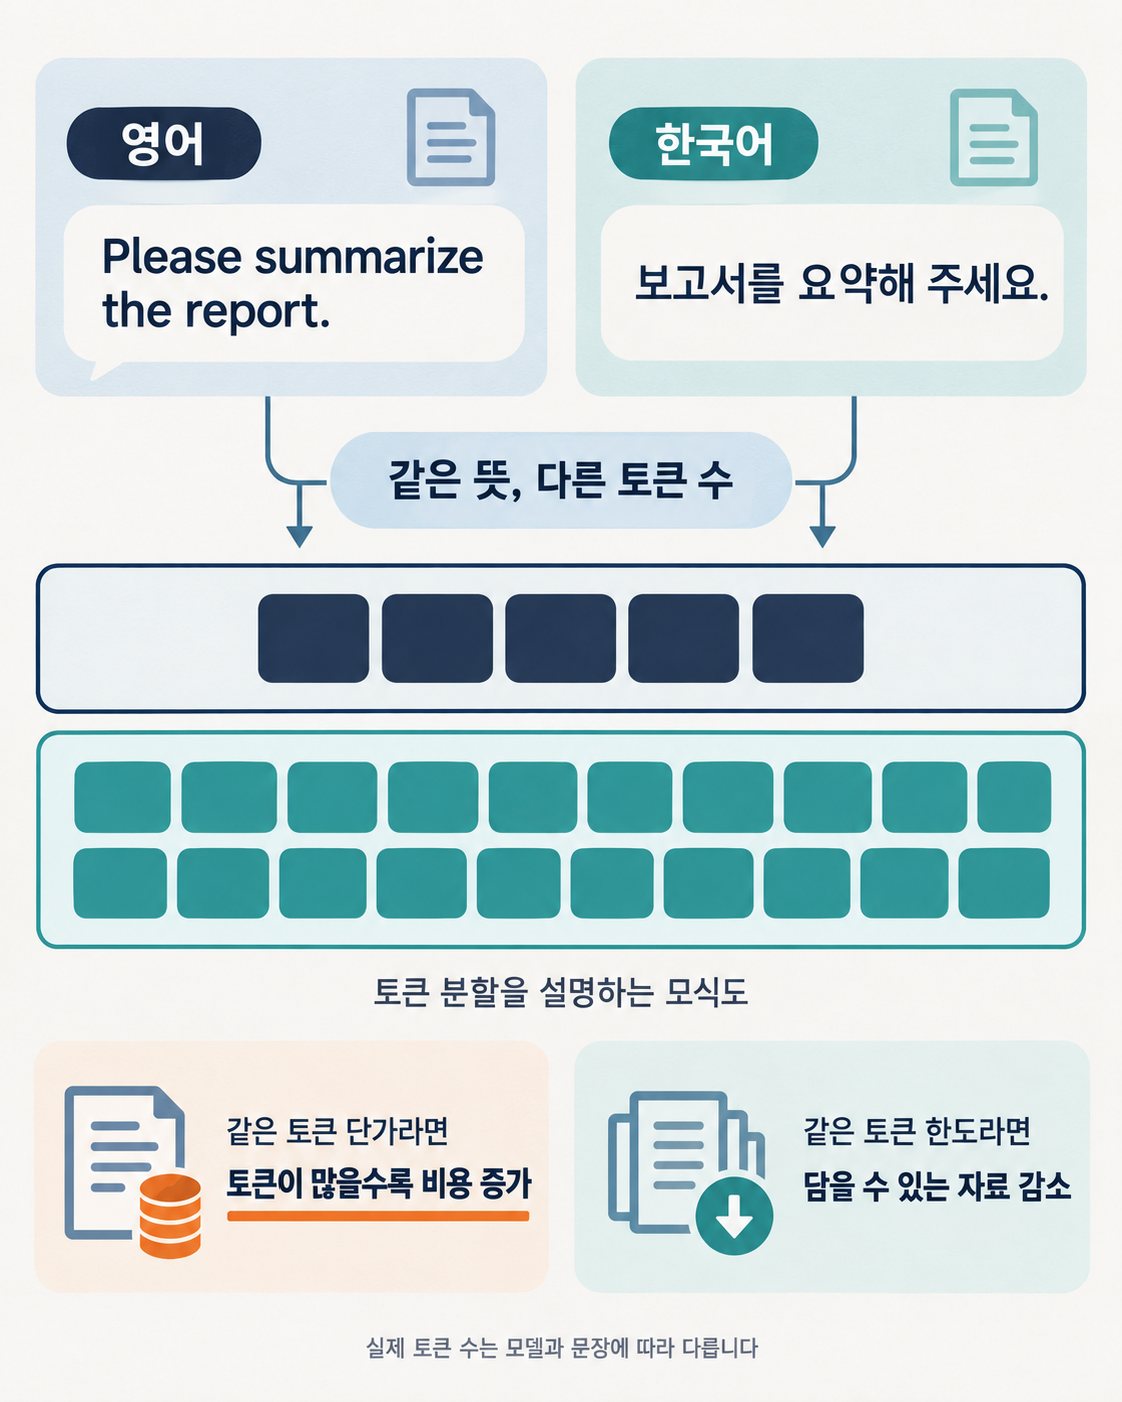
한국어와 영어의 의미가 동일하더라도 토큰의 수는 달라집니다
AI는 글자를 그대로 받지 않고 토큰(token)이라는 조각으로 잘라서 받습니다. 이 토큰은 우리가 생각하는 낱말이나 의미 덩어리와 꼭 맞지 않고, 요금과 한 번에 넣을 수 있는 자료의 양이 이 토큰의 수로 정해집니다.
Petrov et al.(2023)의 연구는 같은 내용을 여러 언어로 옮겨 토큰의 수를 비교했는데, 언어에 따라 많게는 열다섯 배까지 차이가 났습니다. 한국어가 늘 열다섯 배라는 뜻은 아니고, 여러 언어와 토크나이저를 견주어 본 가장 큰 차이입니다. 같은 해 Ahia et al.(2023)은 스물두 개 언어로 당시 OpenAI API의 비용과 성능을 함께 분석했는데, 영어가 아닌 많은 언어의 사용자가 더 많은 값을 내면서 더 낮은 성능을 받고 있었습니다.
다만 이것은 토큰 수만큼 값을 치르는 API의 이야기이고, 월 이용료를 내는 서비스에서 한국어 사용자가 돈을 더 낸다는 뜻은 아닙니다. 그리고 이 격차는 고정된 것도 아닙니다. SK텔레콤은 2025년에 공개한 A.X 4.0이 같은 한국어 입력을 GPT-4o보다 약 33% 적은 토큰으로 처리한다고 모델 설명서에 밝혔습니다. 개발사의 발표이지만, 한국어의 처리 효율이 모델을 어떻게 만드느냐에 따라 달라진다는 것을 보여 줍니다.
토큰의 수와 이해의 깊이는 따로 봐야 합니다
토큰을 많이 사용했다고 해서 뜻을 덜 알아듣는 것도, 더 잘 알아듣는 것도 아닙니다. 값이 얼마나 드는지와 업무에 필요한 지식을 갖추었는지는 따로 확인해야 합니다.
Son et al.(2024)이 공개한 한국어 평가 KMMLU는 영어 시험을 번역하지 않고 국내의 실제 시험에서 45개 분야, 35,030개 문항을 모았습니다. 이 평가에서 당시 가장 뛰어난 상용 모델이던 GPT-4의 평균 정확도는 59.95%, 하이퍼클로바X(HyperCLOVA X)는 53.40%였습니다.
그러나 이 숫자를 지금의 한계로 읽으시면 곤란합니다. 2026년에 네이버클라우드가 낸 기술 보고서는 HyperCLOVA X 32B Think의 KMMLU 점수를 71.3으로 보고했습니다. 모델과 평가 조건이 달라 두 숫자를 빼서 나아진 폭을 셈할 수는 없지만, 2년 사이에 판이 달라졌다는 것은 알 수 있습니다.
띄어쓰기보다 생략을 먼저 봅니다
그렇다고 한국어의 모양을 억지로 바꾸는 요령이 답은 아닙니다. 실무에서 더 자주 생기는 실패는 토큰의 문제가 아니라 빠진 정보의 문제입니다.
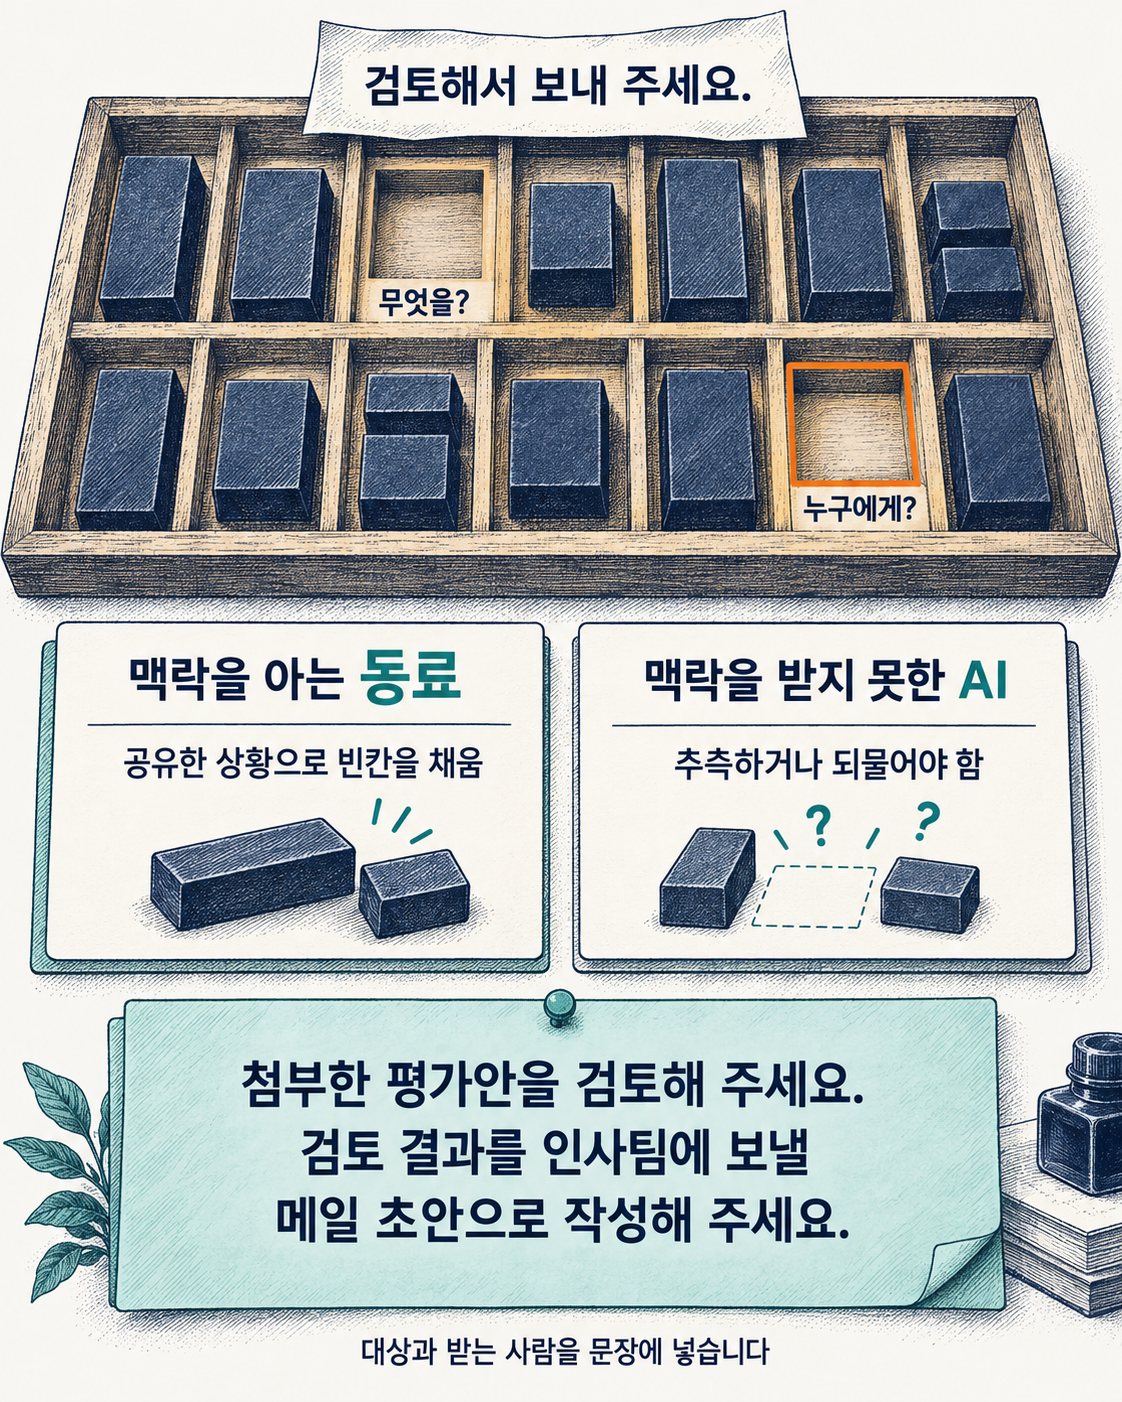
한국어는 주어와 목적어를 자주 생략하고, 서로 맥락을 알고 있다면 그것은 자연스러운 말하기입니다. "검토해서 보내 주세요"라는 말을 들은 동료는 함께 일하던 상황으로 무엇을 검토해 누구에게 보낼지 알아챕니다. 그러나 그 맥락을 받지 못한 AI는 빈자리를 짐작으로 채우거나 되물어야 합니다. "한국어로 명확하게 질문했는데, 답변이 기대한 것과 다릅니다"라는 말은 대개 이 자리에서 나옵니다.
인사 제도 개선 방안을 알려 주세요. 대상은 직원 300명 규모의 제조 회사이고, 목적은 평가 결과에 대한 불만을 줄이는 것입니다. 개선 방안은 세 가지로 제시하고, 방안마다 예상되는 반발을 함께 적어 표로 정리해 주세요.
"인사 제도 개선 방안을 알려 주세요"라는 짧은 요청과 이 요청의 차이는 띄어쓰기나 문법에 있지 않습니다. 누구를 위해, 무엇을 목적으로, 어떤 모양의 결과를 받을지를 문장으로 채워 넣었다는 데 있습니다. 여기에 "판단에 꼭 필요한 정보가 빠졌으면 먼저 물어봐 주세요"를 덧붙이시면 AI가 짐작하는 자리가 한 번 더 줄어듭니다.
그렇다면 영어로 물어야 할까
제 답은 목적과 조건을 가장 정확히 설명할 수 있는 언어, 대개는 한국어로 요청하되 몇 자리만 영어의 도움을 받으라는 것입니다.
첫째, 뜻이 흔들릴 수 있는 전문 용어는 「직무 기술서(Job Description)」처럼 원어를 함께 적어 주십시오. 영어로 통째로 옮기다가 우리 회사의 직급이나 평가 제도 같은 중요한 맥락을 빠뜨리는 쪽이 더 큰 손해입니다. 둘째, 긴 자료를 여러 번 넣는 작업이라면 겹치거나 상관없는 부분은 추리되, 결론을 바꿀 수 있는 조건과 예외는 남겨 두십시오.
셋째, 그림 속 한글은 이제 AI에게 맡겨도 됩니다. 이미지 안에 글자를 그리는 일은 토큰과는 다른 문제인데, OpenAI는 2026년 4월 Images 2.0을 발표하면서 한국어를 비롯한 비라틴 문자의 표현이 크게 나아졌다고 밝혔습니다. 이 글의 그림 두 장도 한글을 함께 넣어 만들었습니다. 다만 넣을 문구를 정확히 적어 주고, 받은 그림은 맞춤법과 빠진 글자를 한 번 확인하시기 바랍니다.
요령으로도 되지 않는 것
여기까지 읽으시고 핵심어를 괄호로 묶거나 강조 기호를 많이 붙이면 된다고 해석하지 않기를 바랍니다. 강조는 요청을 정리하는 데 쓸 수 있지만, 그것만으로 모델이 글을 자르는 방식을 고정하거나 답의 정확성을 보장하지는 못합니다.
한국어의 불리함은 모델과 작업에 따라 다릅니다. 중요한 업무라면 자주 하는 요청 하나를 골라 같은 자료와 조건으로 여러 모델에 맡겨 보시고, 사실이 맞는지와 조건을 빠뜨리지 않았는지를 견주어 보십시오. 내 업무에 맞는 답은 남이 만든 평가표보다 그 비교에서 나옵니다.
그래서 한국어로 질문해서 생기는 손해를 가장 크게 줄이는 방법은 기법이 아니라 문장입니다. 생략한 주어와 목적어, 말하지 않은 목적과 형식을 채워 넣는 일은 어느 언어로 질문하든 사람이 해야 할 일이고, 한국어에서는 그 일이 조금 더 중요할 뿐입니다.
참고한 연구
- Petrov et al., Language Model Tokenizers Introduce Unfairness Between Languages (arXiv:2305.15425, 2023) https://arxiv.org/abs/2305.15425
- Ahia et al., Do All Languages Cost the Same? Tokenization in the Era of Commercial Language Models (arXiv:2305.13707, 2023) https://arxiv.org/abs/2305.13707
- Son et al., KMMLU: Measuring Massive Multitask Language Understanding in Korean (arXiv:2402.11548, 2024) https://arxiv.org/abs/2402.11548
- NAVER Cloud HyperCLOVA X Team, HyperCLOVA X 32B Think (arXiv:2601.03286, 2026) https://arxiv.org/abs/2601.03286
- SK Telecom, A.X 4.0 모델 설명서 (2025) https://huggingface.co/skt/A.X-4.0
- OpenAI, Introducing ChatGPT Images 2.0 (2026) https://openai.com/index/introducing-chatgpt-images-2-0/