AI에게 같은 질문을 했는데, 왜 답이 다르게 나올까?
2026-09-23
AI의 모델과 언어가 답의 성향을 바꾼다
생성형 AI를 쓰시는 분들이 한 번쯤 해 보시는 말이 있습니다.
"AI에게 같은 질문을 했는데, 왜 답이 다르지?"
같은 AI에게 같은 질문을 다시 해도 표현과 내용이 조금씩 달라지는 것은 자연스러운 일입니다. AI는 다음에 올 말을 확률로 골라 문장을 이어 가기 때문이고, 앤트로픽(Anthropic)의 개발 문서도 무작위성을 가장 낮게 설정해도 같은 입력에 다른 출력이 나올 수 있다고 밝히고 있습니다. 이 흔들림은 여러 번 물어 보면 드러납니다.
그런데 이와는 다른 차이가 있습니다. 어떤 AI 모델에게, 어떤 언어로 묻느냐에 따라 답이 일정한 방향으로 기운다는 연구가 나왔습니다. 이 연구가 본 것은 한 질문을 되풀이했을 때의 흔들림이 아니라, 많은 대화를 모았을 때 모델과 언어에 따라 드러나는 평균적인 성향의 차이입니다.
30만 건의 대화에서 확인한 것
앤트로픽 연구진은 2026년 7월, Claude.ai에서 오간 실제 대화 309,815건을 분석한 결과를 공개했습니다. 2026년 5월 두 주 동안 사용자가 주관적인 판단이 필요한 일을 맡긴 대화를 세 개의 모델과 가장 많이 쓰이는 스무 개 언어에서 고르게 모아, 답 속에 어떤 가치가 드러나는지를 살폈습니다. 답이 맞았는지가 아니라, AI가 무엇을 더 중하게 여기며 답하는지를 본 것입니다. 과업과 주제, 사용자가 드러낸 가치의 차이를 걸러 낸 뒤에도 모델과 언어에 따라 답의 성향이 달라졌습니다.
답의 성향을 보여 주는 네 개의 축
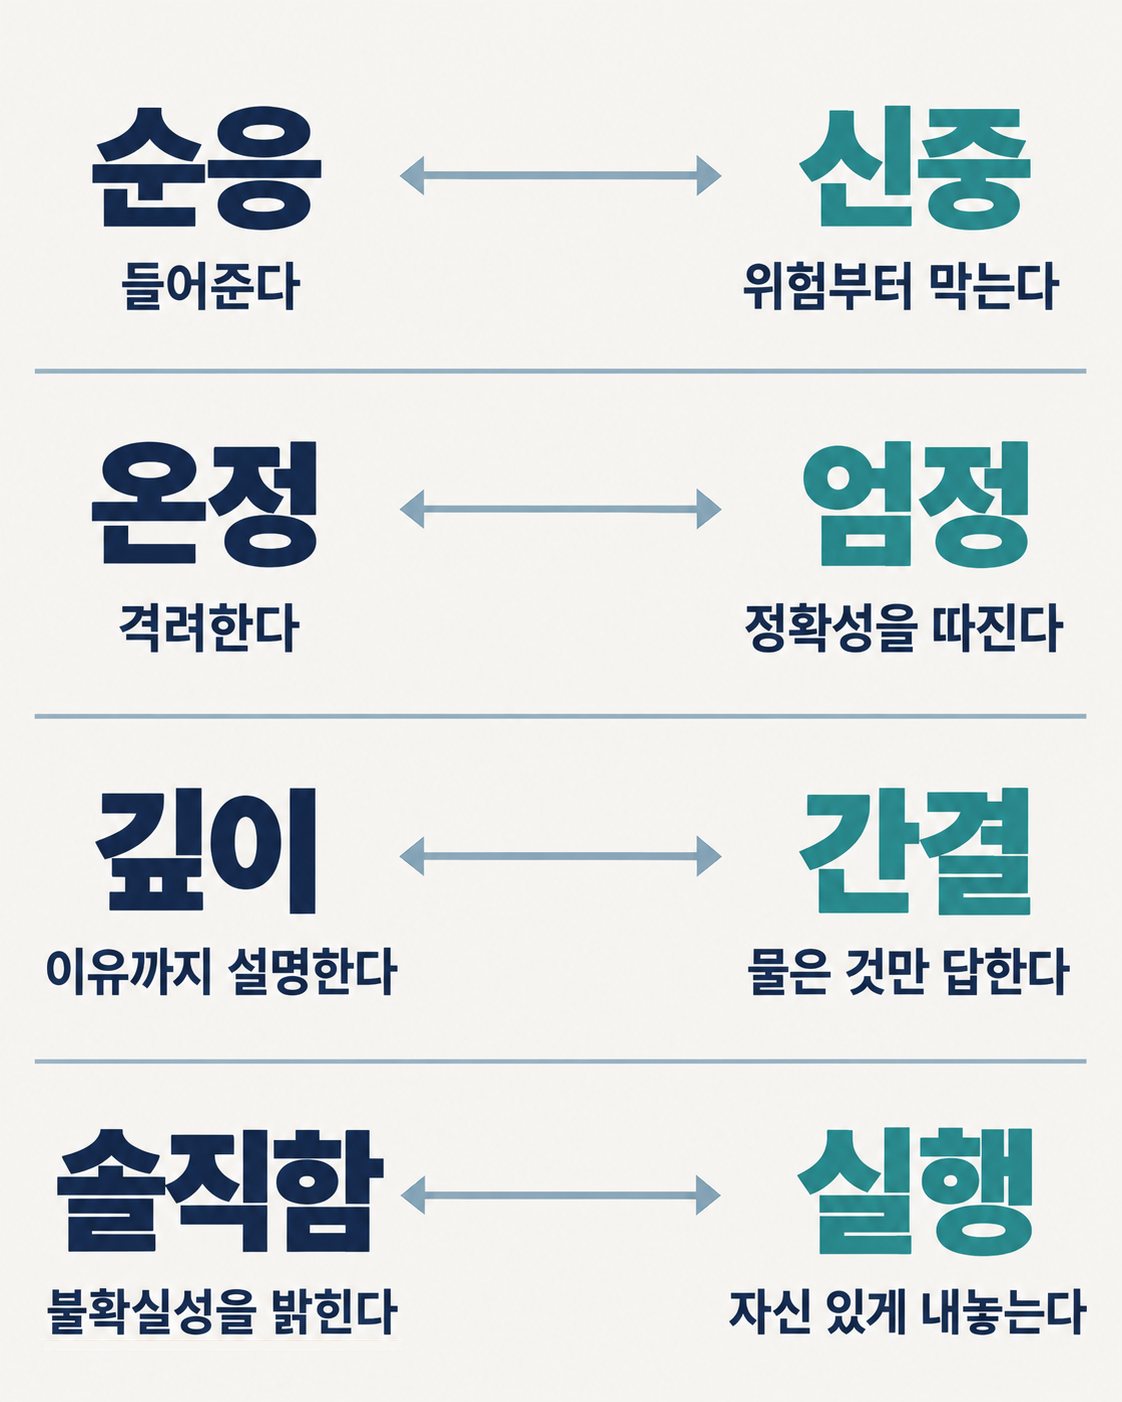
연구진은 수천 개의 가치 표현을 네 개의 축으로 압축했습니다.
첫째는 순응과 신중(Deference ↔ Caution)으로, 사용자가 원하는 것을 들어주는 쪽인지 생길 수 있는 위험을 먼저 막는 쪽인지를 봅니다. 둘째는 온정과 엄정(Warmth ↔ Rigor)으로, 상대를 격려하는 쪽인지 정확성을 따지는 쪽인지를 봅니다. 셋째는 깊이와 간결(Depth ↔ Brevity)로, 이유까지 길게 설명하는지 물은 것만 답하는지를 봅니다. 넷째는 솔직함과 실행(Candor ↔ Execution)으로, 자기 답의 불확실성을 먼저 밝히는지 다듬어진 답을 자신 있게 내놓는지를 봅니다.
모델마다, 언어마다 기울기가 다릅니다
모델별로 보면 Sonnet 4.6은 온정과 순응 쪽으로 기울어, 사용자의 생각을 긍정하고 말투를 맞추는 모습이 더 자주 나타났습니다. Opus 4.7은 신중과 깊이 쪽으로 기울어, 잘못된 전제를 되묻고 묻지 않은 위험까지 짚는 모습이 더 자주 나타났습니다.
언어별 차이는 온정과 엄정, 솔직함과 실행의 두 축에서 컸습니다. 힌디어에서 가장 온정 쪽으로, 러시아어에서 가장 엄정 쪽으로 기울었습니다. 연구진은 같은 사업계획서에 대한 의견을 한 사람은 힌디어로, 다른 사람은 러시아어로 물으면 계획의 질에 대해 서로 다른 인상을 받을 수 있다는 예를 들었습니다. 한국어의 결과도 연구 페이지의 그림에 실려 있습니다. 한국어 대화 15,570건에서 Claude는 순응, 온정, 간결, 솔직함 쪽으로 조금씩 기울었고, 가장 크게 기운 쪽은 간결이었습니다. 판단 없이 위로하고, 사용자의 말투와 격식에 맞추고, 유머를 섞는 모습이 두드러졌다고 합니다. 다만 모두 0.1 표준편차에 못 미치는 작은 기울기이고, 여러 대화의 평균이지 한국어로 물을 때마다 그런 답을 받는다는 뜻은 아닙니다.
첫 번째 나온 답을 정답으로 받지 않습니다
제가 이 연구에서 얻은 가장 큰 시사점은 AI의 첫 번째 나온 답을 정답으로 받아들이기보다 다른 관점에서 한 번 더 검토해 보아야 한다는 것입니다. 그 답에도 모델과 언어에 따른 성향이 반영되어 있을 수 있기 때문입니다.
그래서 저는 중요한 사업계획서나 강의 자료를 만들 때 AI에게 한 번만 묻지 않습니다. 먼저 초안을 쓰게 하고, 이어서 이렇게 묻습니다.
이 계획의 가장 큰 위험은 무엇인가요? 반대 의견을 가진 투자자의 입장에서 이 계획을 비판해 주세요.
같은 AI라도 검토의 관점을 바꾸어 주면 놓쳤던 위험을 발견하기도 하고 더 나은 생각을 얻기도 합니다. 여러 관점을 맞대어 보는 방식에 관한 연구도 있습니다. Du et al.(2023)은 여러 개의 언어 모델이 각자의 답과 추론을 내놓고 여러 차례 서로 토론하게 했더니, 수학과 전략 과제의 추론이 나아지고 사실과 다른 답이 줄었다고 보고했습니다. 같은 AI에게 관점을 바꾸어 다시 묻는 것과 여러 AI가 토론하는 것은 방식이 다르지만, 한 번의 답에 머물지 않는다는 점에서 방향이 같습니다. 저는 AI를 하나의 정답을 내놓는 도구라기보다 여러 관점을 탐색하게 돕는 사고의 동반자에 가깝다고 봅니다.
관점을 바꾸어도 되지 않는 것
여기까지 읽으시고 AI가 언어마다 다른 성격을 가졌다고 해석하지 않기를 바랍니다. 연구진도 분석한 것은 답에 드러난 가치 표현이지, AI가 그 가치를 본래 지니고 있다는 뜻은 아니라고 선을 그었습니다. 네 개의 축도 과업과 주제, 사용자가 드러낸 가치의 차이를 걸러 낸 뒤 대화 사이 가치 표현 차이의 15% 정도를 설명할 뿐입니다. 차이는 작지만 구조가 있고 잡아낼 수 있다는 것이 연구진의 표현입니다.
왜 그런 차이가 생기는지도 아직 확정되지 않았습니다. 연구진은 언어마다 학습 데이터의 양이 고르지 않은 것을 하나의 가능성으로 들었을 뿐이고, 그 차이가 바람직한지는 판단을 미루었고 사용자에게 어떤 영향을 주는지는 측정하지 않았습니다. 그래서 저는 관점을 바꾸어 여러 번 묻는 일을 치우침을 드러내는 방법으로 쓰지만, 그것으로 치우침이 없어졌다고 보지는 않습니다. 어느 관점의 답을 택할지는 끝까지 사람이 판단해야 합니다.
참고한 연구
- Anthropic, Claude's values vary by model and language (2026) https://www.anthropic.com/research/claude-values-models-languages
- Anthropic, Glossary — Temperature, Claude 개발 문서 https://platform.claude.com/docs/en/about-claude/glossary
- Du et al., Improving Factuality and Reasoning in Language Models through Multiagent Debate (arXiv:2305.14325, 2023) https://arxiv.org/abs/2305.14325