규칙을 길게 쓰면 더 잘 지킬까
2026-09-28
분량만이 아니라 구조가 준수율을 정한다
생성형 AI를 업무에 오래 쓰신 분들은 지시문이 점점 길어지는 경험을 하십니다. 한 번 틀리면 규칙을 한 줄 더하고, 다른 문제가 생기면 예외를 덧붙입니다. 그렇게 모인 지시문이 수백 줄이 되면 이상한 일이 생깁니다. 분명히 적어 둔 규칙을 AI가 지키지 않는 것입니다.
규칙을 한 줄 더하기 전에 살펴볼 것이 세 가지 있습니다. 중요한 정보가 어디에 있는지, 한꺼번에 지켜야 할 조건이 몇 개인지, 지켰는지 확인할 수 있는 문장인지입니다.
긴 글에서는 정보의 자리가 영향을 줍니다
스탠퍼드 대학과 UC 버클리 연구진의 「Lost in the Middle」(Liu et al., 2024)은 여러 문서 가운데서 답을 찾는 과제와 긴 목록에서 값을 찾는 과제를 평가했습니다. 필요한 정보가 입력의 처음이나 끝에 있을 때 성능이 가장 높았고, 가운데에 있을 때 크게 떨어졌습니다.
다만 이 연구가 본 것은 정보를 찾는 성능이지 규칙을 지키는 정도는 아닙니다. 그래서 「가운데 적은 규칙은 무시된다」고 옮기면 과장입니다. 중요한 조건을 긴 배경 설명 속에 묻어 두지 말고, 목적과 반드시 지킬 기준을 눈에 띄는 자리에 따로 적어 두라는 근거로 삼는 정도가 알맞습니다.
조건이 늘면 함께 지키기 어려워집니다
지시의 개수는 따로 보아야 합니다. 「How Many Instructions Can LLMs Follow at Once?」(Jaroslawicz et al., 2025)는 업무 보고서에 정해 준 단어를 넣으라는 지시를 10개에서 500개까지 늘려 20개 모델을 평가했습니다. 지시 500개에서는 가장 뛰어난 모델도 68%만 지켰고, 앞쪽에 적힌 지시를 더 잘 지키는 경향도 보였습니다. 제약을 하나씩 더해 간 FollowBench(Jiang et al., 2024)에서도 조건이 늘수록 모든 모델의 성능이 크게 떨어졌습니다. 이 연구는 조건 하나하나를 지킨 비율과 한 요청의 조건을 모두 지킨 비율을 따로 평가했는데, GPT-4 같은 모델도 연달아 지킨 조건이 평균 세 개 안팎이었습니다. 일부 조건을 잘 지킨 것과 요청 전체를 지킨 것은 다릅니다.
그렇다고 필요한 조건까지 지우라는 뜻은 아닙니다. 같은 뜻을 두 번 적은 규칙, 이번 일에는 필요 없는 조건부터 정리하라는 뜻입니다. 빠진 조건이 보일 때마다 한 줄씩 더하는 습관은 이 문제를 더 키울 수 있습니다.
중심 문서는 짧게, 세부 규칙은 주제별로
앤트로픽(Anthropic)의 Claude Code 공식 문서는 지시 파일 하나를 200줄 미만으로 쓰라고 권하며, 파일이 길수록 맥락을 더 쓰고 지시를 지키는 정도가 떨어진다고 적고 있습니다. 특정 도구의 권고이지 모든 AI의 경계선은 아닙니다.
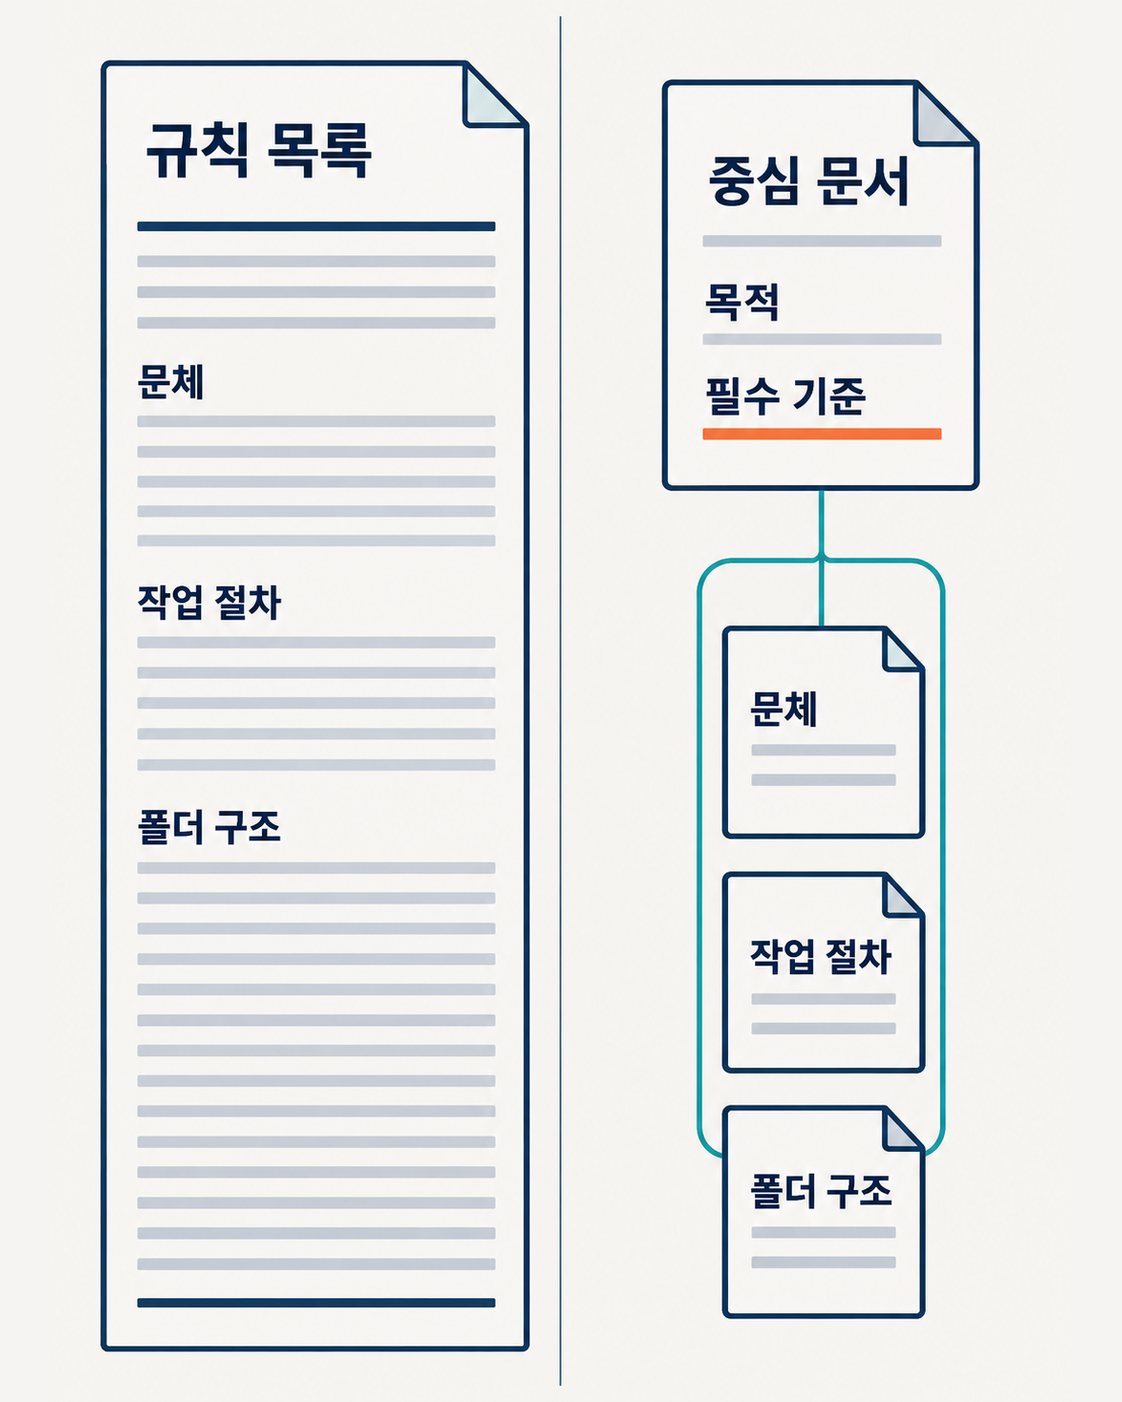
그래서 저는 중심 문서는 짧게 두고 「무엇을」만 적습니다. 문체, 작업 절차, 폴더 구조처럼 「어떻게」에 해당하는 규칙은 주제별 문서로 나누어 둡니다. 기준이 바뀌면 한 곳만 고치면 되고, AI가 규칙을 지키지 않을 때 어느 문서의 어느 규칙이 문제인지 찾을 수 있습니다.
주의할 점이 있습니다. 나눈 문서를 매번 전부 불러오면 AI가 받는 분량은 줄지 않습니다. 같은 문서도 참조로 불러온 파일은 함께 맥락에 들어간다고 밝히고 있습니다. 나누는 일과 이번 일에 필요한 문서를 골라 주는 일은 다른 일입니다.
규칙을 지켰는지 확인할 수 있는 문장으로
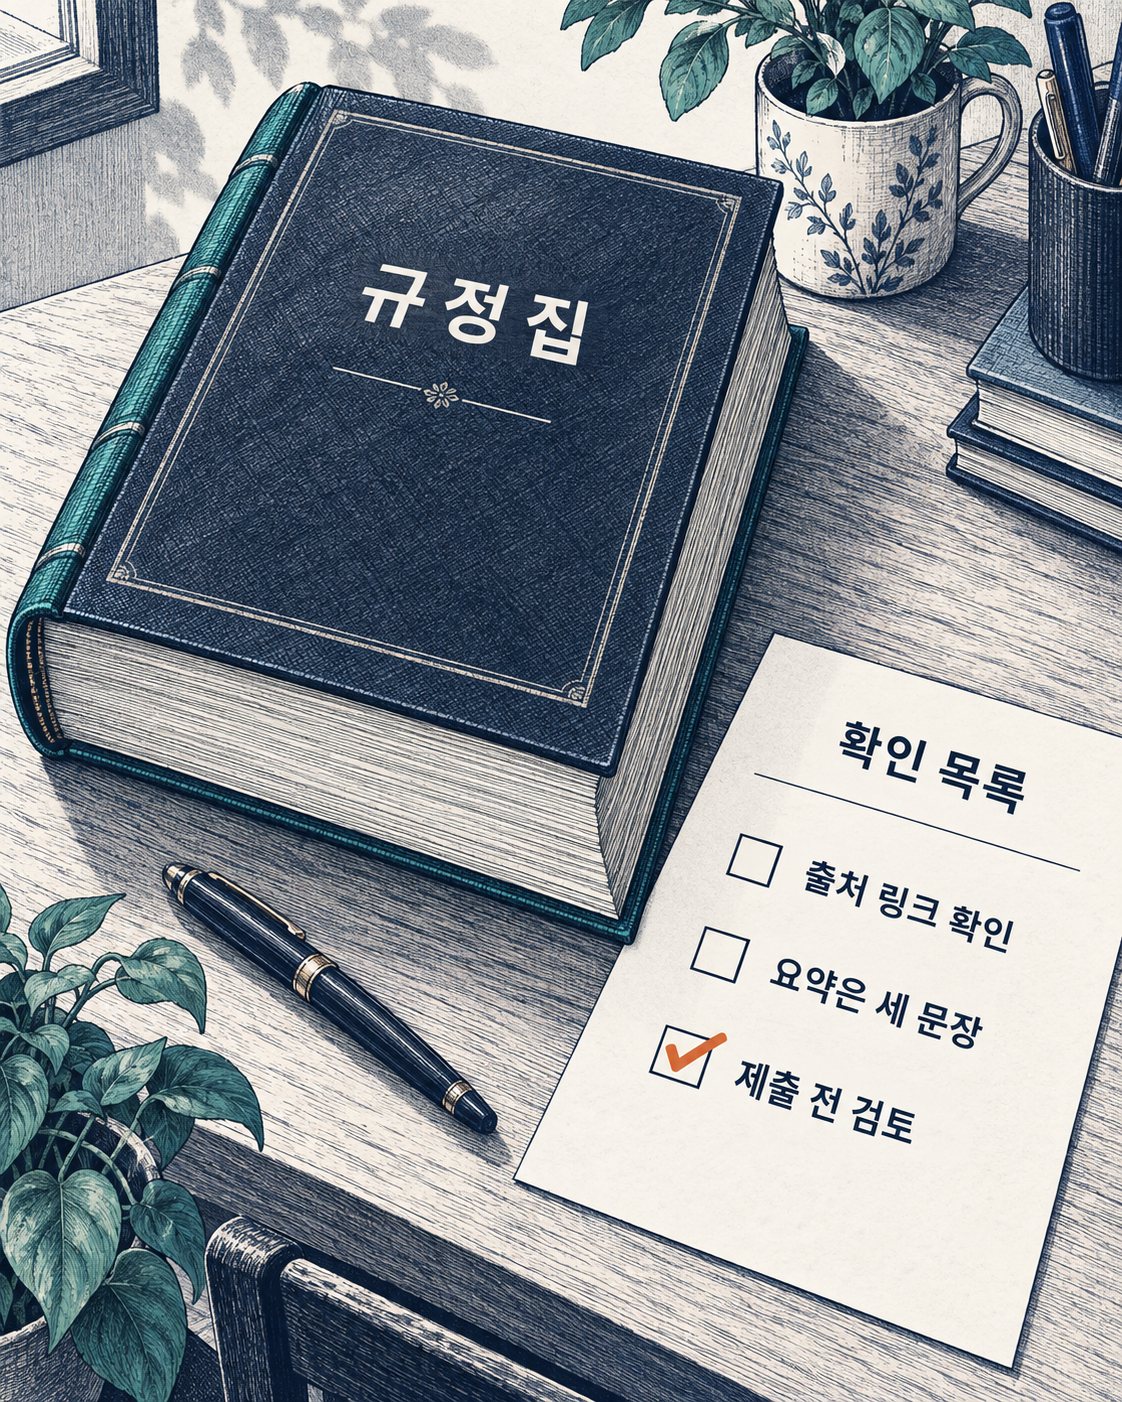
구조만큼 중요한 것이 문장입니다. 같은 문서는 「검증할 수 있을 만큼 구체적으로」 쓰라고 권합니다. 「코드를 제대로 정리하라」 대신 「들여쓰기는 두 칸」, 「변경한 것을 시험하라」 대신 「올리기 전에 시험 명령을 돌린다」처럼 씁니다. 업무 문서라면 「짧게 요약해 주세요」보다 「요약은 세 문장으로」가 지켰는지 확인하기 쉽습니다.
세종시 AI 행정혁신 액션러닝에서 공무원분들과 실습하면서도 반복해서 확인하는 원칙입니다. 프롬프트는 명령이 아니라 구조입니다.
잘 설계된 구조로도 해결되지 않는 것
구조를 잘 갖추어도 모든 규칙이 지켜지는 것은 아닙니다. 앤트로픽 문서도 지시 파일은 강제 설정이 아니라 맥락이어서 엄격히 지킨다는 보장이 없고, 두 규칙이 서로 어긋나면 어느 한쪽을 임의로 고를 수 있다고 밝히고 있습니다. 앞의 두 연구도 주로 영어 과제로 평가한 결과여서 한국어 업무에 같은 수치를 옮길 수는 없습니다. 그래서 규칙을 고친 뒤에는 같은 자료로 다시 요청해 전에 놓친 조건을 이번에는 지켰는지 확인합니다. 반드시 지켜야 할 조건을 확인하는 일까지 지시문에 맡길 수는 없습니다.
참고한 연구
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts, TACL 12 (arXiv:2307.03172, 2024) https://aclanthology.org/2024.tacl-1.9/
- Jaroslawicz et al., How Many Instructions Can LLMs Follow at Once? (arXiv:2507.11538, 2025) https://arxiv.org/abs/2507.11538
- Jiang et al., FollowBench: A Multi-level Fine-grained Constraints Following Benchmark for Large Language Models, ACL 2024 (arXiv:2310.20410, 2024) https://aclanthology.org/2024.acl-long.257/
- Anthropic, How Claude remembers your project, Claude Code 공식 문서 (2026-09-28 확인) https://code.claude.com/docs/en/memory