더 똑똑한 모델이 답도 더 좋을까
2026-10-03
사람의 비판적 사고가 더 중요한 이유
2025년 4월, 저는 블로그에 「2025년 AI IQ 테스트 결과 총정리: 어떤 AI가 가장 똑똑할까?」라는 제목으로 AI IQ 테스트 결과를 정리한 적이 있습니다. AI 성능 비교 사이트인 트래킹 AI(Tracking AI)가 사람용 IQ 문제와 AI가 학습하지 않은 새 문제로 주요 모델을 평가한 결과였습니다. 새 모델이 나올 때마다 이런 순위표가 돌고, 많은 사람이 맨 윗자리의 모델을 찾습니다. 그렇다면 순위가 높은 모델을 쓰면 자신의 일의 답도 정말 더 좋아질까요?
점수는 어떤 시험지로 평가했느냐에 따라 달라집니다
그 순위표를 다시 보면 눈에 띄는 점이 있습니다. 당시 트래킹 AI의 원자료로 다시 계산해 보면, 구글의 제미나이 2.5 프로는 멘사 노르웨이 테스트에서 128점이었지만 학습하지 않은 새 문제로 본 오프라인 테스트에서는 115점이었습니다. 오픈AI의 o1도 122점에서 100점 안팎으로 내려갔습니다. 같은 모델이라도 어떤 시험지를 쓰느냐에 따라 점수가 크게 달라진 것입니다.
트래킹 AI를 운영하는 맥심 로트(Maxim Lott)도 2024년에 인터넷에 올린 적 없는 새 문제로 시험해 보니, AI들의 점수가 평균 6점쯤 낮았다고 밝혔습니다. 다만 상위 모델은 3점 차에 그쳤고, 로트는 이것이 곧 부정행위를 뜻하지는 않는다고 덧붙였습니다. 연구자들은 공개된 시험 문제가 학습 데이터에 섞여 점수가 부푸는 현상을 벤치마크 오염이라고 부릅니다. 바스크대학교 연구진의 「NLP Evaluation in trouble」(2023)은 모델이 시험 문제를 학습 데이터로 이미 본 경우 그 시험의 성능이 실제보다 높게 평가된다고 지적했습니다. 스케일 AI 연구진이 널리 쓰이는 초등 수학 시험(GSM8k)과 형식·난이도를 맞춘 새 문제(GSM1k)로 모델을 평가했을 때도 정확도가 최대 8% 떨어지는 모델들이 있었습니다. 다만 최상위 모델에서는 그런 징후가 적었다고 함께 적었습니다.
당시 글에도 적었듯이, 특정 시험에서 높은 점수를 받았다고 해서 모든 상황에서 똑똑하게 행동하는 것은 아닙니다. 순위표가 알려 주는 것은 그 시험지에서의 성적이지, 자신의 일에서의 성적이 아닙니다.
같은 문제, 다른 답
2025년 2월에는 여러 생성형 AI 모델에 같은 퍼즐을 두 가지 형태로 주어 보았습니다. 노인과 버스, 학사모가 들어간 그림 퍼즐은 시험한 모델이 모두 틀렸습니다. 같은 내용을 이모지 텍스트로 바꾸자 o1, o3-mini, 딥시크 R1 등 여러 모델이 정답 9를 맞혔습니다. 무료 ChatGPT는 14라는 오답을 냈다가, 추론 기능을 선택하자 9를 맞혔습니다. 모델을 새로 고르지 않고 입력의 형태와 설정만 바꾸어도 답이 달라진 것입니다.
2025년 12월에는 논리 문제 하나로 ChatGPT와 제미나이를 직접 시험했습니다. 황금 열쇠가 사라진 파티에서 네 사람이 진술하고, 그 가운데 정확히 한 사람만 거짓말을 한다는 조건이 붙은 문제였습니다. 그런데 이 문제는 따져 보면 풀리지 않습니다. A와 C 가운데 한 사람은 반드시 거짓말을 하고, B와 D 가운데서도 한 사람은 반드시 거짓말을 하기 때문입니다.
결과는 모델과 방식에 따라 달랐습니다. ChatGPT의 5.1 모델은 문제만 주었을 때 A가 거짓말을 했고 B가 훔쳤다고 답했습니다. 200달러 요금제에서 주어지는 고급 추론 기능인 Pro 모델은 C를 지목하다가, 답의 모순을 지적하자 그제야 조건을 만족하는 답이 없다고 했습니다. 제미나이의 기본 모델은 방식마다 다른 사람을 지목했습니다. 제미나이의 Deep Think 모델만 세 가지 방식 모두에서 문제 자체가 성립하지 않는다고 답했습니다.
주어진 조건을 모두 만족하는 상황은 논리적으로 불가능하므로, 거짓말을 한 사람과 열쇠를 훔친 사람을 특정할 수 없습니다.
이전 글(AI에게 같은 질문을 했는데, 왜 답이 다르게 나올까?)에서도 다루었지만, 답의 차이는 모델 이름만으로 설명되지 않습니다. 같은 서비스 안에서도 어떤 모델과 어떤 프롬프트를 쓰느냐에 따라 다른 결과가 나옵니다.
깊이 생각하는 모델과 빨리 답하는 모델
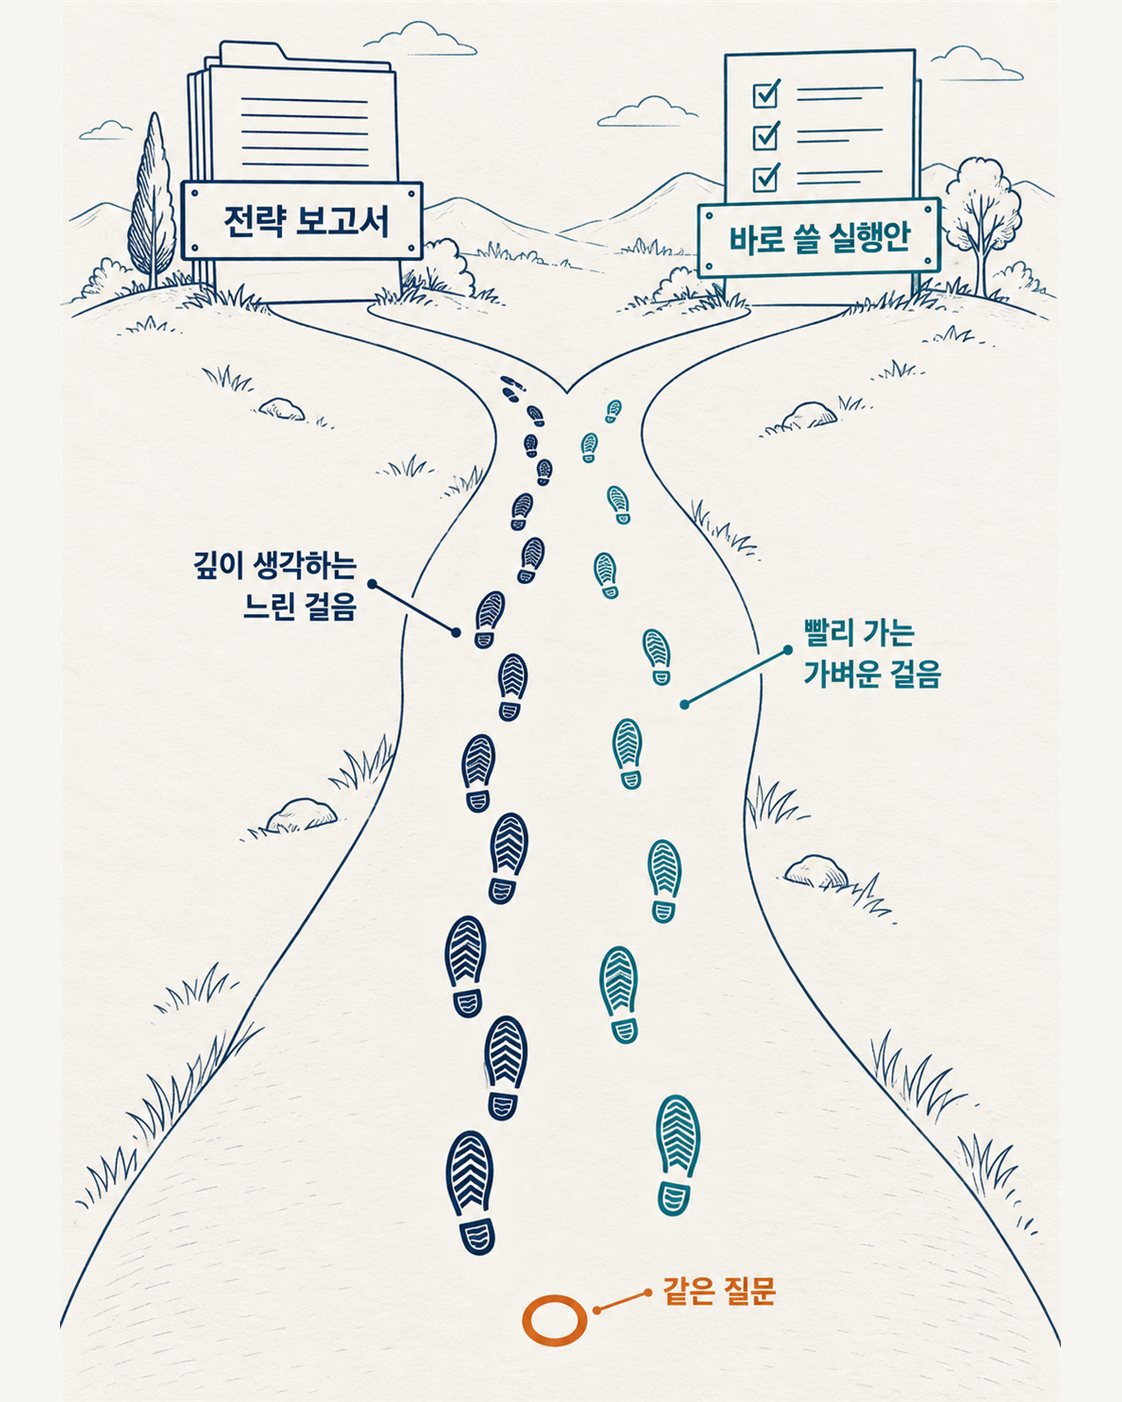
2025년 2월 1일에는 오픈AI의 o1과 o3-mini에 같은 질문 세 가지를 주고 답을 비교했습니다. 대기업의 조직문화 개선 전략을 정리하는 일, 인사팀의 성과관리 방안을 조언하는 일, 스타트업의 브랜드 스토리 아이디어를 내는 일이었습니다. o1은 학술 연구와 이론을 바탕으로 한 보고서 초안과 MBO·OKR·BSC 비교처럼 깊이 있는 답을 내놓았지만, 처리 속도가 비교적 느렸습니다. o3-mini는 바로 쓸 수 있는 실행 방안과 성과관리 템플릿을 훨씬 빨리 내놓았습니다.
어느 쪽이 더 좋은 답인지는 질문한 사람이 무엇을 원하느냐에 달려 있었습니다. 연구나 전략 기획처럼 깊이가 필요한 일에는 o1이, 실무 조언이나 고객 상담처럼 속도와 실행이 중요한 일에는 o3-mini가 맞았습니다. 더 똑똑한 모델이 아니라 일에 맞는 모델이 더 좋은 답을 냈습니다.
순위표 밖에 있는 네 가지 기준
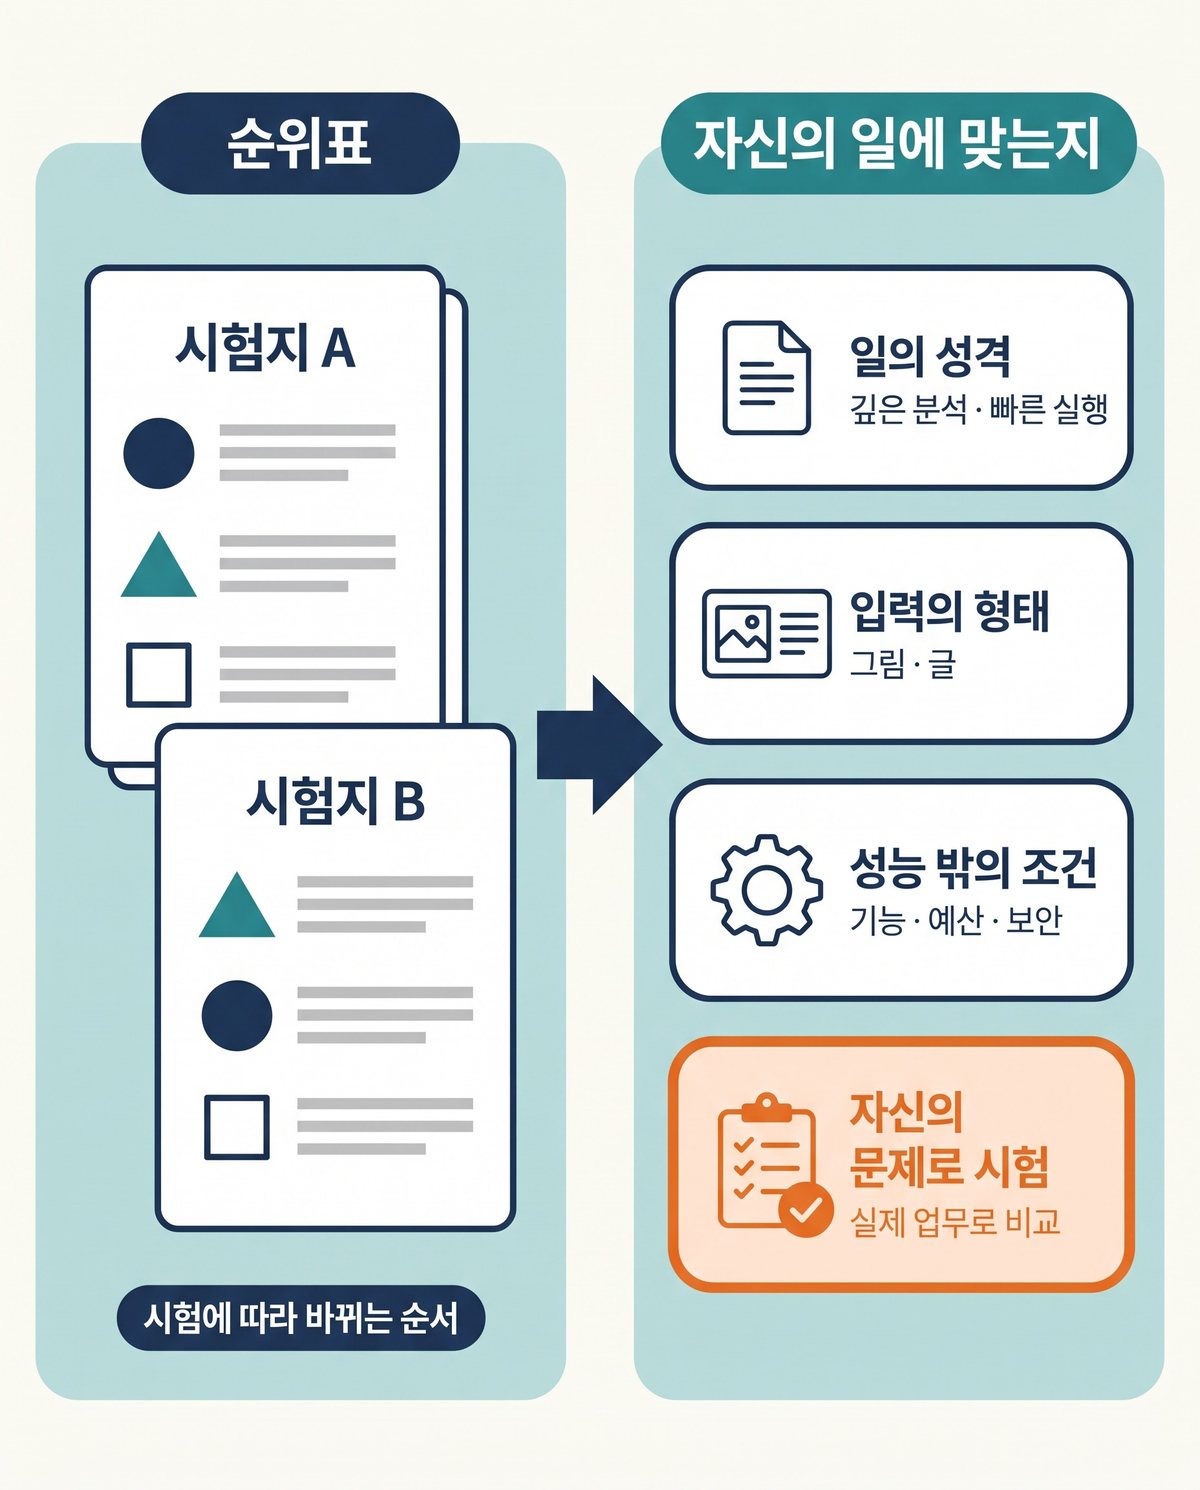
이 비교들을 모아 보면 모델을 고르는 기준은 순위표 밖에 있습니다.
첫 번째는 일의 성격입니다. 깊은 분석이 필요한 일인지, 빠른 실행이 필요한 일인지부터 정합니다. 모델마다 잘하는 일이 다르기 때문입니다. 스탠퍼드대학교 기초모델연구센터(CRFM)가 2025년 3월 발표한 평가(HELM Capabilities)에서 평균 점수 1위는 제미나이 2.0 플래시였지만, 과제별 1위는 대부분 다른 모델이었습니다. 지식·추론 과제에서는 클로드 3.7 소넷이, 지시 따르기에서는 팔미라-X-004가, 대화에서는 딥시크 V3가 가장 높았습니다. 2025년 11월 AI타임스가 전한 한 대학생의 수능 풀이 실험에서도 국어 100점은 제미나이 3 프로뿐이었고, 수학 100점은 GPT-5.1과 클로드 소넷 4.5였습니다.
두 번째는 입력의 형태입니다. 같은 내용이라도 그림으로 주느냐 글로 주느냐에 따라 결과가 달라질 수 있습니다.
세 번째는 성능 밖의 조건입니다. 딥시크 R1과 ChatGPT o1을 비교한 글에서 저는 어떤 모델을 선택하든 필요한 기능과 예산, 개발 편의성을 함께 고려해야 하고, 보안 우려가 있는 모델은 더 신중하게 결정해야 한다고 적었습니다.
네 번째는 자신의 문제로 직접 시험해 보는 것입니다. 앞의 비교들처럼 실제로 할 일을 여러 모델과 설정에 넣어 보면, 순위표가 알려 주지 않는 차이가 드러납니다. AI 평가 기관 METR이 2025년 경력 많은 오픈소스 개발자 16명과 한 무작위 대조 실험에서는, AI 도구를 써도 되게 한 과제가 오히려 19% 더 오래 걸렸습니다. 연구진은 이 결과를 현장에서 AI의 능력이 흔히 쓰는 벤치마크 결과보다 낮을 수 있다는 근거의 하나로 보았습니다. 코딩 한 분야에서 16명으로 한 실험이지만, 시험 점수와 자신의 일의 성적이 같지 않다는 점을 보여 줍니다.
기준을 세워도 남는 것
다만 이 기준에도 한계가 있습니다. 여기서 든 비교는 당시 블로그에 적은 몇 개의 문제로 해 본 것이라, 같은 결과가 언제나 되풀이된다고 말할 수는 없습니다. 모델 이름도 이미 옛 이름이 되었습니다. o1과 o3-mini, 제미나이 2.5 프로가 앞자리에 있던 순위표는 지금 그대로 쓸 수 없습니다. 순위는 몇 달 만에 바뀌지만, 무엇을 기준으로 고를지는 그만큼 빨리 바뀌지 않습니다. 그리고 어떤 기준으로 골라도 모델이 틀리지 않는다는 보장은 없습니다. 황금 열쇠 문제에서도 여러 모델이 성립하지 않는 문제에 그럴듯한 답을 내놓았습니다. 두 모델 모두 완벽하지 않으며 사용자의 비판적 사고가 여전히 중요하다는 것이 그때 제가 남긴 결론이었습니다. 어떤 모델을 쓰든, 답을 받아들일지는 사람이 판단해야 합니다.
참고한 연구
- 트래킹 AI(Tracking AI), 「IQ Test 원자료(2025년 4월 17일 보관본)」, 2025 http://web.archive.org/web/20250417004420/https://trackingai.org/app/database/proj_IQ/score_logs/iq/daily_logs.csv
- 맥심 로트(Maxim Lott), 「AI IQ scores (mostly) confirmed, using new offline IQ test」, Maximum Truth, 2024 https://www.maximumtruth.org/p/ai-iq-scores-mostly-confirmed-using
- Sainz 외, 「NLP Evaluation in trouble: On the Need to Measure LLM Data Contamination for each Benchmark」, 2023 https://arxiv.org/abs/2310.18018
- Zhang 외, 「A Careful Examination of Large Language Model Performance on Grade School Arithmetic」, NeurIPS Datasets and Benchmarks, 2024 https://arxiv.org/abs/2405.00332
- Stanford CRFM, 「HELM Capabilities」, 2025 https://crfm.stanford.edu/2025/03/20/helm-capabilities.html
- AI타임스, 「“제미나이 3로 2026 수능 풀어보니”...GPT-5.1 누르고 압도적 1위」, 2025 https://www.aitimes.com/news/articleView.html?idxno=204103
- Becker 외(METR), 「Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity」, 2025 https://arxiv.org/abs/2507.09089